Data Engineering
про инжиниринг данных и аналитику
🏢 %company% Engineering
AirBnb Engineering
последний пост 3 weeks, 6 days назад
CASTLE: training natural language search before the first real query
CASTLE: training natural language search before the first real query CASTLE: training natural language search before the first real query

How we addressed the cold-start problem for Airbnb’s natural language search by jointly generating synthetic training data — queries and relevance labels — from de-identified booking and search signals.By: Wendy Ran Wei, Hao Li, Weiwei Guo, Xiaowei Liu, Xueyin Chen, Chun How Tan, Malay Haldar, Soumyadip Banerjee, Kedar Bellare, Huiji Gao, Sanjeev Katariya, and Stephanie MoyermanIntroductionNatural language search lets guests express intent in their own words, such as “romantic cabin near skiing” or “pet-friendly beach house that sleeps eight,” rather than navigating filters and categories. We needed to introduce this kind of search for Airbnb, and to have it work well from the start. Howeve…

3 weeks, 6 days назад @ medium.com
Beyond synthetic testing: Capturing and replaying real database workloads at Airbnb
Beyond synthetic testing: Capturing and replaying real database workloads at Airbnb Beyond synthetic testing: Capturing and replaying real database workloads at Airbnb

How we capture real production database traffic at Airbnb and replay it offline to load-test, plan capacity, and de-risk upgrades.By: Zuofei Wang, Erluo LiIntroductionAt Airbnb, MySQL-compatible databases are a critical backbone of our online database infrastructure: a fleet of hundreds of clusters supporting thousands of use cases at millions of queries per second (QPS). Operating databases at scale brings hard problems, including sizing clusters for future growth, keeping behavior consistent across version upgrades and migrations, and reproducing production incidents well enough to debug them. This post describes the database traffic capture and replay system we built to help us tackle th…

1 month назад @ medium.com
Personalization without user identity
Personalization without user identity Personalization without user identity

How Airbnb uses proximity signals to personalize without relying on individual user history.By: Wei Jiang, Bin Xu, Bharathi Thangamani, Weiwei Guo, Sundar Srinivasavaradhan, Tracy Yu, Huiji Gao, Swapnil Ghike, Michael KinotiGreat personalization starts with knowing your user. But what happens when the user is a stranger?A significant share of Airbnb users arrive without a login, without a recent search history, or without any prior booking — especially those landing from paid advertising or organic search. For these users, the ML models that power search ranking, destination recommendations, and marketing landing pages face the cold-start problem: there is little to no user signal available…

1 month, 1 week назад @ medium.com
The guest journey, updated in real time: extending Airbnb’s sequence recommender with Chronon
The guest journey, updated in real time: extending Airbnb’s sequence recommender with Chronon The guest journey, updated in real time: extending Airbnb’s sequence recommender with Chronon

How two new Chronon capabilities, Push Mode and NRT Model Transform, allows us to provide more relevant search results instantly as a guest explores, rather than waiting for the next batch run.By: Pengyu Hou, Yuli Han, Daochen Zha, Haozhen Ding, Xin Liu, Sophie Wang, Pallavi Adusumilli, Sherry Li, Henry Saputra, Chun How Tan, Huiji Gao, Yan Zhang, Stephanie Moyerman, Yi Li, and Sanjeev KatariyaA guest’s interaction with Airbnb doesn’t pause to wait for a nightly batch job. Someone might browse a dozen listings on a Tuesday afternoon, run a new search that evening, and expect the next search to reflect the recent activity; it’s also to Airbnb’s benefit for that to be the case. In our previou…

1 month, 3 weeks назад @ medium.com
Beyond the Model: Engineering AI Infra with Scientific Judgement
Beyond the Model: Engineering AI Infra with Scientific Judgement Beyond the Model: Engineering AI Infra with Scientific Judgement

How Airbnb’s agent harness transforms unstructured data exploration by encoding scientific methodology into scalable, reproducible, and audit-ready infrastructure.Wren DoughertyAsk a coding agent to analyze 100,000 customer support conversations and within minutes you’ll have a polished taxonomy, precise prevalence numbers, and an executive-ready summary. What you can’t see is the investigation that produced them: the methods it chose, the evidence it weighed, how much to trust it, or whether a second request would agree. All that reaches you is the polish. The model is undeniably intelligent, but intelligence without methodology is not science.LLMs certainly make for confident scientists, …

1 month, 3 weeks назад @ medium.com
Project Lighthouse — Part 3: Introducing project-lighthouse-anonymize
Project Lighthouse — Part 3: Introducing project-lighthouse-anonymize Project Lighthouse — Part 3: Introducing project-lighthouse-anonymize

Project Lighthouse — Part 3: Introducing project-lighthouse-anonymizeThe data in Project Lighthouse is powered by privacy-preserving anonymization code. We’ve put this code into open source, and published two new technical papers detailing the scalable algorithms and data quality frameworks behind it.By: Adam BloomstonIntroductionIn 2020, we launched Project Lighthouse, which we developed in partnership with leading civil rights and privacy organizations. As our 2020 announcement details, Project Lighthouse enables us to measure potential disparities in user experiences. This work uses perceived race data that is never linked to individual accounts; we only use this data for measuring poten…

2 months, 2 weeks назад @ medium.com
How we knew COVID was over (and what our models had to unlearn)
How we knew COVID was over (and what our models had to unlearn) How we knew COVID was over (and what our models had to unlearn)

When we retrain, when we rebuild, and when we leave a model alone.By: Harrison KatzA forecast that carries weightThe Forecasting Data Science team at Airbnb produces many of the forecasts the rest of the company plans around: demand, bookings, cancellations, and a range of finer cuts by market and segment, refreshed continuously across thousands of markets. The targets differ, and the models differ, but they have one thing in common: Other teams build on top of them.This means a forecast that is casually wrong is not a clean miss, as it might be in an academic setting. That’s because a small bias does not stay small once a lot of decisions are riding on it. So when one of those forecasts st…

2 months, 3 weeks назад @ medium.com
Flexible Authentication: Reimagining authentication for millions of users at Airbnb
Flexible Authentication: Reimagining authentication for millions of users at Airbnb Flexible Authentication: Reimagining authentication for millions of users at Airbnb

Rebuilding login and signup surfaced product insights, not just technical challenges. Here’s how we designed Flexible Authentication at the intersection of product intuition and technical architecture.By: Jose Santos, Mike BarryFor Airbnb, logins at irregular intervals are normal. A guest books a trip in January and may not open the app again until summer. A host checks back only when a reservation comes in, and may be busy with other activities when it does. For a two-sided marketplace where a failed login means a lost booking, and lost revenue for both the guest and the host, long gaps between sessions are a structural challenge, not an edge case.Our authentication system had grown organi…

2 months, 4 weeks назад @ medium.com
Eval-driven development: Lessons from evaluating GenAI at scale
Eval-driven development: Lessons from evaluating GenAI at scale Eval-driven development: Lessons from evaluating GenAI at scale

How Airbnb teams build trustworthy Generative AI products by treating evaluation as a first-class engineering discipline; not an afterthought.Nestled into the lush hillside, this stunning modern retreat features striking natural wood architecture, terraced balconies, and a serene landscape.By: Rohit Girme, Dan Miller, Mia Zhao, Lifan Yang, Clint KellyIntroductionGenerative AI breaks a lot of the assumptions that used to hold true for software testing. Unlike traditional software, LLM outputs are non-deterministic, and “correct” is subjective. Because so much judgment is involved, you often need an AI to evaluate an AI, which introduces its own potential failure modes. Making matters more co…

3 months, 2 weeks назад @ medium.com
Personalizing Airbnb search by learning from the guest journey
Personalizing Airbnb search by learning from the guest journey Personalizing Airbnb search by learning from the guest journey

How we built a Transformer-based sequence model that encodes years of guest behavior to surface the right listings at the right time.By: Daochen Zha, Chun How Tan, Xin Liu, Bin Xu, Han Zhao, Xiaowei Liu, Jun Shi, Tracy Yu, Hui Gao, Huiji Gao, Liwei He, Michael Kinoti, Stephanie Moyerman, and Sanjeev KatariyaIntroductionPlanning a trip on Airbnb rarely happens in a single session. A guest searching for a place to stay in San Francisco might browse dozens of listings over several days, leaving behind a trail of views. Typically, over a period of years, that same guest will have accumulated many previous bookings, reviews, and the occasional cancellation. Taken together, these events reveal a …

3 months, 3 weeks назад @ medium.com
From weeks to a day: how we made LLM evaluation fast enough to iterate on
From weeks to a day: how we made LLM evaluation fast enough to iterate on From weeks to a day: how we made LLM evaluation fast enough to iterate on

Training an LLM is the easy part. The hard part is designing experiments and evaluations that you can trust enough to know whether the new model is actually an improvement.By: Baharak SaberidokhtIntroductionShipping a production LLM system means iterating fast on improvements to something that is, by construction, non-deterministic. Models drift, judges disagree with themselves, references regenerate as different strings, and bugs may persist until the next release, because retraining takes weeks. Most of this friction comes from infrastructure challenges, not model quality, and the fixes come from classical software engineering techniques.At Airbnb, we built reliable LLM infrastructure by …

3 months, 4 weeks назад @ medium.com
Scaling beyond one: How Airbnb evolved its data architecture for a multi-product world
Scaling beyond one: How Airbnb evolved its data architecture for a multi-product world Scaling beyond one: How Airbnb evolved its data architecture for a multi-product world

How Airbnb’s data engineers and analytics engineers built a consistent and flexible data modeling framework to support the expansion into Homes, Experiences, and Services.By: Patrick Lam, Namrata Lamba, Jamie StoberWith the May 2025 Summer Release, Airbnb redesigned its app, relaunched Experiences, and debuted Services, pushing us beyond our traditional Homes focus. For the data teams, this meant rapidly evolving a decade-old infrastructure to integrate two brand-new product pillars. Our data engineers and analytics engineers rose to the challenge by building a consistent and flexible framework to serve as a robust and scalable data foundation for the next decade of growth.But getting there…

5 months назад @ medium.com
Sitar-agent: Building a reliable dynamic configuration sidecar at scale
Sitar-agent: Building a reliable dynamic configuration sidecar at scale Sitar-agent: Building a reliable dynamic configuration sidecar at scale

How Airbnb built a Kubernetes sidecar to deliver dynamic configuration reliably at scale.By: Bo Teng, Cosmo Qiu, Siyuan Zhou, Ankur Soni, Xin Huang, Willis HarveyIntroductionIn our previous post, we explored Airbnb’s dynamic configuration system, Sitar, with a focus on service architecture and configuration change safety. Now for the harder question: once a config change is committed, which happens several times each minute, how does it actually reach the thousands of Airbnb’s service instances reliably, quickly, and without redeploying the services?This post describes sitar agent: a lightweight Kubernetes sidecar that runs alongside every subscribed service pod, continuously synchronizing …

5 months, 1 week назад @ medium.com
When history fails you, borrow from geography
When history fails you, borrow from geography When history fails you, borrow from geography

How Airbnb used sequential geographic recovery signals and prior propagation to generate reliable corridor-level forecasts when local data was scarce.By: Harrison KatzThe problem with unprecedented shocksAlmost every forecasting system is built on the same implicit assumption: the future will resemble the past. You train on historical data, you validate on holdout periods, and you trust that past patterns will at least roughly indicate future performance. When this assumption breaks, the model does not gracefully degrade; it fails confidently. It produces precise, well-calibrated intervals around the wrong answer.The acute phase of COVID, from early to late 2020, was a clear illustration of…

5 months, 1 week назад @ medium.com
Scaling Airbnb’s identity graph with a unified knowledge graph infrastructure
Scaling Airbnb’s identity graph with a unified knowledge graph infrastructure Scaling Airbnb’s identity graph with a unified knowledge graph infrastructure

How Airbnb shifts from PaaS to an internal knowledge graph infrastructure at scale.By: Lucen Zhao, Shukun Yang, Ashish JainKnowledge graphs offer a natural and powerful way to represent relationships between entities. Many real-world systems are fundamentally about connections.Airbnb’s identity graph captures relationships between users in a graph database. The identity graph serves aggregated insights that enable user identity resolution and relationship understanding. These capabilities support a wide range of Trust and Safety use cases, from detecting suspicious activities to identifying linked accounts. Over time, the identity graph has grown into one of the largest and most complex gra…

5 months, 3 weeks назад @ medium.com
Netflix Engineering Netflix Engineering
последний пост 7 часов назад
Fact-Checking at Scale: Building a More Accurate and Efficient Synopsis Factuality System
Fact-Checking at Scale: Building a More Accurate and Efficient Synopsis Factuality System Fact-Checking at Scale: Building a More Accurate and Efficient Synopsis Factuality System

By Shreya S Ramanujam, Yongce Li, Afshine Amidi, Sina Ghiassian, Benjamin Klein.IntroductionPicture this — you’re home after a long day at work and can’t wait to catch up on Bridgerton. You log on to Netflix, search for “Bridgerton” and land on this screen:If this sounds familiar, you already know what a synopsis is — it’s a short glimpse into what a viewer can expect to see in a show. We see two types of synopses here: a series-level synopsis describing the overarching plot, and multiple episode-level synopses describing each episode.A synopsis plays a very important role for us — it helps viewers decide whether a title is worth watching or not. Every synopsis needs to strike a balance: sh…

7 часов назад @ netflixtechblog.com
Making Failure Diagnosis Reliable with Pensive AI
Making Failure Diagnosis Reliable with Pensive AI Making Failure Diagnosis Reliable with Pensive AI

By Praneeth Yenugutala, Victor Dusa, Anastasia Samoilova, Megan Ren, Justin Wei, Marcelo MaywormAt Netflix, data and machine learning practitioners run millions of workloads each day across orchestration systems and compute engines such as Titus, Spark, Trino, and Druid. On peak days, roughly 100,000 workloads fail. When workloads fail, the failure itself is only the beginning. Someone still needs to find the useful signal in several logs, decide whether the cause sits in their code or the platform, and determine whether to retry, reconfigure, or escalate. Even a small share of difficult failures can consume engineering time, waste compute, and interrupt critical data pipelines.Our first an…

2 weeks назад @ netflixtechblog.com
Multi‑Ratio Video Resizing for Mobile Feed and Marketing
Multi‑Ratio Video Resizing for Mobile Feed and Marketing Multi‑Ratio Video Resizing for Mobile Feed and Marketing

Serdar Cellat, Yuchen Xie, Bernadette Marcu, Blaid Burgess, Cody Jarrett, Carlos Pereira, Qing Shi, Samuel Carvajal, Manuel Pamplona, Dorothy Jung, Feiko Ritsema, Benjamin Klein, Alex Woo, Eugene Lok, Anna Pulido, Rebecka Swe, Sanford HolsappleIntroductionClips in the Netflix mobile app.At Netflix, a crucial part of our mission is ensuring our content looks stunning on any device. Vertical formats are increasingly important for Netflix, as we have 1.2B followers across our social media accounts, and have recently rolled out Clips, our vertical video feed in the Netflix mobile app. Traditionally, creating vertical assets meant editors and producers manually reframed horizontal videos in edit…

2 weeks назад @ netflixtechblog.com
Beyond API Compatibility: Building a Tool to Measure the Blast Radius of Library Changes
Beyond API Compatibility: Building a Tool to Measure the Blast Radius of Library Changes Beyond API Compatibility: Building a Tool to Measure the Blast Radius of Library Changes

By Roberto Perez Alcolea, Java Platform TeamQuasar connects a proposed API change with observed references in consumer repositories, giving the producer evidence for a release decisionAt Netflix, shared Java libraries support applications developed across a large, independently evolving repository ecosystem. A library change begins in one repository, but its impact can reach many others. Producers can see the API diff in front of them. What they often cannot see is who still depends on the symbols that changed.The need for that visibility grows as coding agents take on more of the software development lifecycle. An agent can accelerate a local edit, but without cross-repository context it c…

2 weeks, 3 days назад @ netflixtechblog.com
Single-tenant Titus: VM-level isolation on a multi-tenant container platform
Single-tenant Titus: VM-level isolation on a multi-tenant container platform Single-tenant Titus: VM-level isolation on a multi-tenant container platform

Samartha Chandrashekar & Nick ParkerYou click play on a Friday night, and in the second that follows, dozens of services answer in milliseconds. Most of them run on Titus, our internal container platform. Titus is, in essence, a Kubernetes-based container hosting platform: we keep both the control plane and the data plane (the container hosts that actually run containers) patched and up to date, so application teams get a consistent and reliable container experience. They hand us a container, and we run it, with no host, cluster, or kernel to own. Titus launches millions of containers every week across tens of thousands of EC2 instances in multiple AWS regions. It is multi-tenant by default…

2 weeks, 4 days назад @ netflixtechblog.com
Single-tenant Titus: VM-level isolation on a multi-tenant container platform
Single-tenant Titus: VM-level isolation on a multi-tenant container platform Single-tenant Titus: VM-level isolation on a multi-tenant container platform

Samartha Chandrashekar & Nick ParkerYou click play on a Friday night, and in the second that follows, dozens of services answer in milliseconds. Most of them run on Titus, our internal container platform. Titus is, in essence, a Kubernetes-based container hosting platform: we keep both the control plane and the data plane (the container hosts that actually run containers) patched and up to date, so application teams get a consistent and reliable container experience. They hand us a container, and we run it, with no host, cluster, or kernel to own. Titus launches millions of containers every week across tens of thousands of EC2 instances in multiple AWS regions. It is multi-tenant by default…

2 weeks, 4 days назад @ netflixtechblog.com
Ontology-Driven Observability: Building an End-to-End Knowledge Graph at Netflix Scale
Ontology-Driven Observability: Building an End-to-End Knowledge Graph at Netflix Scale Ontology-Driven Observability: Building an End-to-End Knowledge Graph at Netflix Scale

Prasanna Vijayanathan, Renzo Sanchez-SilvaWhen Jake Paul and Mike Tyson stepped into the ring in November 2024, we delivered the fight to roughly 65 million concurrent streams. On an ordinary day our infrastructure takes in more than 2 billion requests and handles upwards of 38 million real-time logging events every second. At that scale, the whole picture doesn’t fit into a single engineering team’s head or onto a single dashboard. With more Live content, Podcasts and real-time streams, our need to understand and update our systems as quickly as possible becomes imperative to provide a good user experience. Understanding the system at this scale and within the time constraints we have, oft…

3 weeks, 3 days назад @ netflixtechblog.com
Integrating Netflix’s Foundation Model into Personalization applications
Integrating Netflix’s Foundation Model into Personalization applications Integrating Netflix’s Foundation Model into Personalization applications

Authors: Divya Gadde, Ko-Jen Hsiao, Dhaval Patel and Moumita BhattacharyaThe motivation for building the Netflix Foundation Model for personalization was laid out in this previous blog post. The Netflix homepage is powered by several specialized models and it requires significant time and resources to maintain and continue innovating on these individual models. Therefore, we decided to centralize member preference learning and have one powerful model learned from comprehensive user interaction histories and content data at a large scale and have this model distribute its learnings to other models.The previous two blog posts(1, 2) focus on the development of the Foundation Model and here we …

3 weeks, 5 days назад @ netflixtechblog.com
DataJunction as Netflix’s answer to the missing piece of the modern data stack
DataJunction as Netflix’s answer to the missing piece of the modern data stack DataJunction as Netflix’s answer to the missing piece of the modern data stack

by Olek Gorajek, Samuel Redai, Yian ShangIntroOur Netflix journey from data to dashboards, particularly within the space of the experimentation platform, always presented a unique set of challenges. This blog post aims to illuminate these hurdles and explain how an innovative open-source metric platform became instrumental in overcoming some of them. We’ll showcase the critical role that DataJunction played in streamlining our data workflows and enhancing our ability to derive meaningful insights from our vast datasets.Metrics are the foundation of data-driven decision-making, but at many organizations, they are scattered, inconsistently defined, and difficult to discover or trust. At Netfl…

3 weeks, 5 days назад @ netflixtechblog.com
Measuring the Impact of Personalized Recommendations
Measuring the Impact of Personalized Recommendations Measuring the Impact of Personalized Recommendations

By Kevin Zielnicki, Guy Aridor, Aurélien Bibaut, Allen Tran, Winston Chou, and Nathan KallusIntroductionPersonalization is everywhere on the internet. It shapes the products we discover, the stories we read, the music we hear, and the movies and TV shows we watch. At Netflix, personalization has been central to the member experience for decades — from the Netflix Prize to our modern recommender system that helps members navigate a large and constantly changing catalog.But personalization is not only an algorithmic problem, it is also a measurement problem. How do we know how much value personalization creates? More precisely, how do we separate the appeal of a title from the value created b…

3 weeks, 5 days назад @ netflixtechblog.com
TimeSeries Tiered Storage Journey: Kafka/Flink Streams to Native Cassandra Cold Reads
TimeSeries Tiered Storage Journey: Kafka/Flink Streams to Native Cassandra Cold Reads TimeSeries Tiered Storage Journey: Kafka/Flink Streams to Native Cassandra Cold Reads

By Oleksii Tkachuk, Rajiv Shringi, Chris Lohfink, Abe Ratnofsky, Kartik SathyanarayananIntroductionIn an earlier post, we introduced the TimeSeries Abstraction, our high-throughput, low-latency platform designed to store and query temporal event data at scale. It has since become the operational backbone for Netflix’s largest datasets, which now span multiple petabytes.However, managing such large datasets in hot storage, tuned for low-millisecond latency access, is not cheap. At Netflix, cost-efficiency is a continuous discipline rather than a temporary initiative. This post shares two solutions that significantly reduce storage costs by continuously moving older, less frequently accessed …

3 weeks, 5 days назад @ netflixtechblog.com
Behind the Scenes: Evolving Netflix’s Ads Event Pipeline for Live — Part II
Behind the Scenes: Evolving Netflix’s Ads Event Pipeline for Live — Part II Behind the Scenes: Evolving Netflix’s Ads Event Pipeline for Live — Part II

By Yogesh NagarurIntroductionIn Part 1 of this series, we shared how Netflix built the Ads Event pipeline and approached it as a system design problem: replacing fragmented pipelines with a centralized collection, enrichment, and a standard data contract. The result was Ads Event Publisher, the system that collects ad telemetry from client devices, enriches it with the context of the ad that was actually served, and publishes a single, unified stream of ad events to every downstream consumer: frequency capping, metrics, billing, measurement partners, and reporting. Any member viewing or account details that move through this pipeline end-to-end are encrypted and handled in accordance with N…

3 weeks, 5 days назад @ netflixtechblog.com
Netflix Conductor: The Next Chapter
Netflix Conductor: The Next Chapter Netflix Conductor: The Next Chapter

Netflix Conductor : The Next Chapterby Aravindan Ramkumar on behalf of the Conductor teamConductor is the workflow orchestration engine Netflix uses to stitch micro-services into reliable, observable business processes.If you’ve followed Conductor from the outside, the last thing you heard was probably the note on its GitHub repository: Netflix discontinued maintenance of Conductor OSS to refocus its resources on the internal fork.That announcement marked the end of the open-source chapter, and from the outside it may have looked like the end of the story. It wasn’t. Internally, Conductor never slowed down. If anything, it grew faster, and the demands of that growth pushed us to rebuild it …

3 weeks, 5 days назад @ netflixtechblog.com
Running Apache Spark experiments in my sleep (and on a plane)
Running Apache Spark experiments in my sleep (and on a plane) Running Apache Spark experiments in my sleep (and on a plane)

By Prashanth Gedde NarayanaswamyAs one of Netflix’s largest and critical data pipelines, member-sessionizer consolidates tens of billions of hourly client events, encompassing user taps, playbacks, and engagement signals, into individual viewing sessions per profile.A quick two-week tuning effort spiraled into two months when standard approaches hit a wall. Because the failures only happened at full production scale, each test took hours, limiting me to just three or four attempts daily. The turning point was changing the goal: instead of trying to speed up a single run, I built a way to run and monitor multiple tests at once and track every result.That mindset led to an unconventional setu…

3 weeks, 5 days назад @ netflixtechblog.com
The Lifecycle of LLM-as-a-Judge: Building, Aligning, and Monitoring at scale
The Lifecycle of LLM-as-a-Judge: Building, Aligning, and Monitoring at scale The Lifecycle of LLM-as-a-Judge: Building, Aligning, and Monitoring at scale

By Emma Yanyang Kong, JJ Tan, Ishan Gupta, Lars Olds, Claire Campbell, David Fagnan, Ratna Kavuri, Rohan Gosain, Veli Balin, Minsu Jang, Louis GarciaIntroductionAny team generating text with an LLM at scale hits the same problem. You cannot evaluate everything manually. You don't know which outputs are great, which are mediocre, and which are harmful, because you simply cannot read them all. The standard solution is LLM-as-a-Judge, a second model that scores the first model’s output as a proxy for human raters. It is fast, cheap, and easy to deploy. However, it introduces a new and critical question: Who evaluates the evaluator? Furthermore, if the judge drifts, quietly degrading and starti…

3 weeks, 5 days назад @ netflixtechblog.com
Pinterest Engineering
последний пост 3 days, 8 hours назад
Safe and Efficient Multi-Epoch Embedding Training
Safe and Efficient Multi-Epoch Embedding Training Safe and Efficient Multi-Epoch Embedding Training

Authors: Shruthi Hariharan | Machine Learning Engineer II; Konish Dutta | Machine Learning Engineer II; Abhinav Naikawadi | Sr. Machine Learning Engineer; Zhihua Zhang | Machine Learning Engineer II; Rakshita Nagalla | Sr. Machine Learning Engineer; Kousik Rajesh* | Machine Learning Engineer II; Matt Lawhon | Staff Machine Learning EngineerTags: Machine Learning, Infrastructure, Recommendation SystemsContent Track: Technical Discussion / Architecture of big components* == work done while at PinterestIntroductionLarge ID embedding tables underpin some of the largest modeling advances at Pinterest, including teacher-model scaling and cross-domain pretraining for ranking and retrieval. These t…

3 days, 8 hours назад @ medium.com
Scaling Model Evaluation at Pinterest with Ray (Part 4)
Scaling Model Evaluation at Pinterest with Ray (Part 4) Scaling Model Evaluation at Pinterest with Ray (Part 4)

Vishnu Arun | Tech Lead, Feature Importance Platform; Anderson Lam | Sr Software Engineer; Andrew Qiu | Machine Learning Engineer I; Helena Xu | Data Scientist I; Tianyou Wang | Data Scientist IIIntroductionIn our multi-part blog series, we have discussed why we chose Ray as a last mile data processing framework, how we integrated Ray into our existing ML Training Infrastructure, and how we enabled efficient Batch Inference at scale. In this blog post, we will discuss how we were able to apply Ray to another critical part of our ML Infrastructure stack: Model Evaluation.In the Ray Batch Inference Blog Post, we ended on a section on accumulators (counters that would allow us to calculate met…

5 days, 8 hours назад @ medium.com
Introducing ModuleLens: Zooming into PyTorch Modules for Human and Agentic Engineering
Introducing ModuleLens: Zooming into PyTorch Modules for Human and Agentic Engineering Introducing ModuleLens: Zooming into PyTorch Modules for Human and Agentic Engineering

Lida Li, Sr. Staff Software Engineer, Product ML InfraIntroductionModern recommendation systems, including those used for ads ranking and content discovery, have grown substantially in scale and complexity. This growth stems from both increasingly large model architectures. The resulting memory footprint often exceeds the capacity of a single GPU, making it necessary to shard production models across multiple GPUs using distributed training techniques such as Distributed Model Parallelism (DMP).This evolution brings challenges to the everyday engineer work on testing and debugging the model code. The bottleneck includes:Local Machine Hardware Limits: Because production models require multi-…

3 weeks назад @ medium.com
From Activity to Intent: Generating User Journeys with LLMs
From Activity to Intent: Generating User Journeys with LLMs From Activity to Intent: Generating User Journeys with LLMs

Lin Zhu | Sr. Staff Machine Learning Engineer; Manan Kalra | Machine Learning Engineer II; Logan Jeon | Sr. Machine Learning Engineer; Ye Liu | Staff Machine Learning Engineer; Xiangyi Chen | Sr. Machine Learning Engineer; Jaewon Yang | Principal Machine Learning Engineer; Jinwen Xu | Manager II, Machine Learning Engineering; Tingting Zhu | Sr. Manager, Engineering; Sudarshan Lamkhede | Director, Machine Learning EngineeringPinterest is built to get inspired and then turn the inspiration into realization — a dinner, a renovation, a wedding, a new skill. That only works if we understand more than the Pin a user just clicked. The useful unit of personalization isn’t the thing someone just cli…

1 month назад @ medium.com
Metrics Board: Building an Agent-ready Metrics Layer
Metrics Board: Building an Agent-ready Metrics Layer Metrics Board: Building an Agent-ready Metrics Layer

Michele Ceccacci; Software Engineer I | Jason Coffman; Sr. Software Engineer | Colm O’Shaughnessy; Software Engineer II | Laura Palmer; Staff Product Manager | Adam Podraza; Manager, Engineering | Surya Karri; Manager, EngineeringAt Pinterest, reliable and trustworthy metrics are behind every decision: from measuring company-wide business performance to evaluating each feature experiment results. Hundreds of data producers — analysts, data scientists, and engineers across Pinterest — create thousands of metrics from our petabyte scale data lake. A metrics ecosystem this size can’t be ad hoc; it has to be organized, scalable, and resilient. So we built Metrics Board: an end-to-end platform t…

1 month назад @ medium.com
Partition Finalization in Pinterest’s Next-Generation DB Ingestion Framework
Partition Finalization in Pinterest’s Next-Generation DB Ingestion Framework Partition Finalization in Pinterest’s Next-Generation DB Ingestion Framework

Qianrui Zhang | Sr Software Engineer, Logging PlatformKanchi Masalia | Software Engineer II, Stream Processing PlatformLiang Mou | Sr Staff Software Engineer, Logging PlatformYi Pan | Principal Engineer, Agent PlatformIntroductionThis is the third post in our series on Pinterest’s next-generation database ingestion framework. Part 1 introduced the DB ingestion framework built on Kafka, Flink, Spark, and Iceberg, and Part 2 covered automated schema evolution. This post tackles another challenge in migrating downstream customers to the new ingestion framework: knowing when data is complete enough to read.We’ll walk through that data completeness challenge and how we solve it: what “partition …

1 month, 2 weeks назад @ medium.com
Beyond Two Towers: Launching the 3-Tower Engagement Co-Train Model (Part 2)
Beyond Two Towers: Launching the 3-Tower Engagement Co-Train Model (Part 2) Beyond Two Towers: Launching the 3-Tower Engagement Co-Train Model (Part 2)

Authors: Longyu Zhao (Staff Machine Learning Engineer), Gwendolyn Zhao (Staff Machine Learning Engineer), Peng Yan (Senior Machine Learning Engineer), Yuanlu Bai (Senior Machine Learning Engineer), Yuan Wang (Senior Machine Learning Engineer), Yao Cheng (Staff Machine Learning Engineer), Ang Xu (Principal Machine Learning Engineer), Zhaohong Han (Manager II, Ads Lightweight Ranking)IntroductionPreviously¹, we launched the next-generation serving stack for standard ads, which we call Nexus. Nexus decoupled candidate generation from scoring and moved us beyond the classic two-tower-only world, enabling richer model architectures while still meeting stringent latency and cost constraints.Build…

1 month, 3 weeks назад @ medium.com
Evolving Pinterest’s Embedding Retrieval Platform
Evolving Pinterest’s Embedding Retrieval Platform Evolving Pinterest’s Embedding Retrieval Platform

Authors: Bowen Zhou | Staff Software Engineer; Shan Gao | Senior Software Engineer; Jingwen Hu | Software Engineer II; Wenjiang Chu | Staff Software EngineerThe Billion-Embedding ChallengeAt Pinterest, the “signal” is our lifeblood. Whether it’s a home decor enthusiast finding the perfect rug or a fashion seeker discovering a new aesthetic, our discovery engine relies on understanding deep semantic relationships to help our users find inspirations. Over the last few years, the explosive growth of embedding-based retrieval has fundamentally transformed how we surface these signals — and at the heart of that transformation is Manas, Pinterest’s in-house distributed search platform.Embedding R…

1 month, 4 weeks назад @ medium.com
Building Pinterest’s VLM Serving Stack on NVIDIA Dynamo
Building Pinterest’s VLM Serving Stack on NVIDIA Dynamo Building Pinterest’s VLM Serving Stack on NVIDIA Dynamo

Lei Pan | Senior Software Engineer; Salina Wu | Senior Software Engineer; Cristian Lopez | Software Engineer I; Guangtong Bai | Staff Software Engineer; Soam Acharya | Principal Engineer; Saurabh Vishwas Joshi | Principal Engineer; Chia-Wei Chen | Staff Software Engineer; Ambud Sharma | Principal EngineerWhy VLM Serving Matters at PinterestPinterest is a visual search and discovery platform, so its AI systems must reason over both language and visual content. Vision-language models (VLMs), which can interpret images, compare visual candidates, and respond naturally to user intent, are becoming the foundation for the next generation of Pinterest experiences: Pinterest Assistant, hybrid searc…

2 months назад @ medium.com
Becoming an AI Team
Becoming an AI Team Becoming an AI Team

John Grass | Sr. Manager, EngineeringA Fundamental TransformationAn AI team is fundamentally more than just a group whose members incorporate AI tools into their existing workflows. The journey to becoming an AI team necessitates a fundamental and comprehensive paradigm shift in how the team defines ownership, engages in strategic planning, and, most critically, executes on its core goals and objectives. This transformation is not merely an addition of new technology; it is a restructuring of the team’s operating model, philosophy, and individual roles.Becoming an AI team requires a holistic shift: team members transition from routine, manual execution to empowered, AI-augmented strategists…

2 months, 1 week назад @ medium.com
Scaling Conditional Learned Retrieval for Pinterest Home Feed
Scaling Conditional Learned Retrieval for Pinterest Home Feed Scaling Conditional Learned Retrieval for Pinterest Home Feed

Devin Kreuzer | Sr. Machine Learning Engineer; Yichi Wang | Machine Learning Engineer I; Sujan Reddy Ale | Machine Learning Engineer I; Zelun Wang | Sr. Machine Learning Engineer; Hongtao Lin | Sr. Machine Learning Engineer; Piyush Maheshwari | Staff Machine Learning EngineerPinterest home feed candidate generation is a large-scale User-to-Pin retrieval problem. A common approach is a two-tower model: a user tower encodes the user, an item tower encodes candidate Pins, and approximate nearest neighbor search retrieves Pins close to the user embedding. But Pinterest users often have multiple intentions at once — planning a renovation, saving recipes, exploring fashion, or organizing travel i…

2 months, 2 weeks назад @ medium.com
Pinner Progression: Better Use-Case Representation Driving Weekly Active User Growth at Pinterest
Pinner Progression: Better Use-Case Representation Driving Weekly Active User Growth at Pinterest Pinner Progression: Better Use-Case Representation Driving Weekly Active User Growth at Pinterest

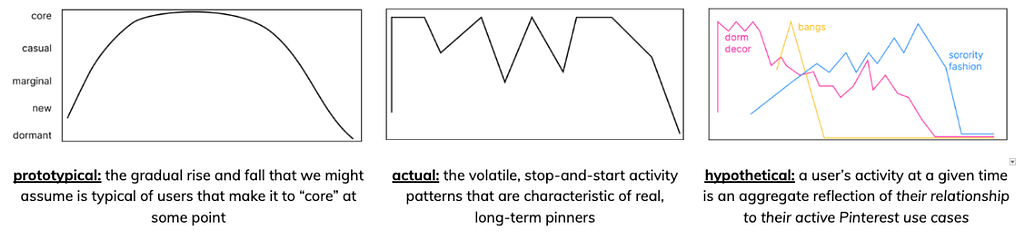
Part 1 of 2AuthorsPersonalization (Homefeed): Yuke Yan, Chuxi Wang, Andreanne Lemay, Olafur Gudmundsson, Anna Kiyantseva, Krystal Benitez, Jongho Kim, Jiacong He, Rahul Goutam, James Li, Dylan WangUser Understanding: Simin Li, Sufyan Suliman, Yingjian Ding, Hongbo DengData Science: Armando Ordorica, Yan Chen, Ellie Zhang, Karim WahbaIntroductionPinterest’s mission is to help people discover the inspiration to create a life they love. Our recommendation system serves hundreds of millions of users, surfacing billions of Pins across interests ranging from home renovation to meal planning to wedding decor. The home feed , where much of that discovery happens, is powered by a multi-stage pipelin…

3 months, 2 weeks назад @ medium.com
Securing Infrastructure at Scale: Introducing Pinterest’s Resource Provisioner Pipeline (RPP)
Securing Infrastructure at Scale: Introducing Pinterest’s Resource Provisioner Pipeline (RPP) Securing Infrastructure at Scale: Introducing Pinterest’s Resource Provisioner Pipeline (RPP)

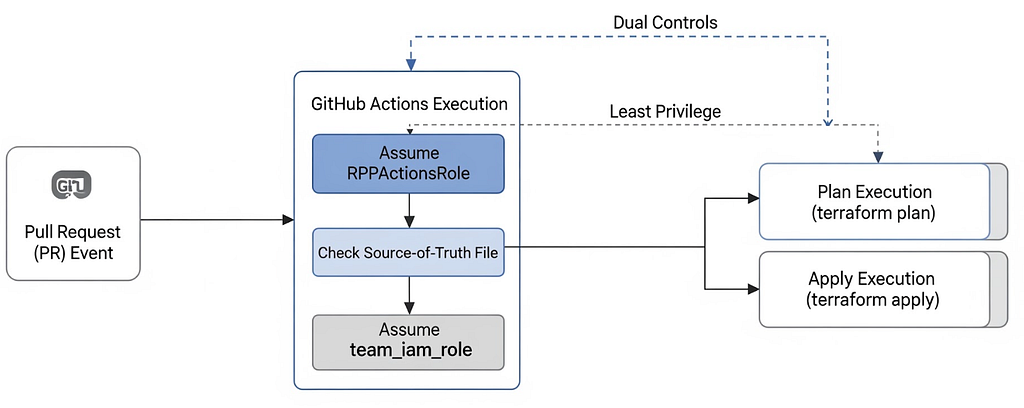
Ammar Ekbote | Senior Software EngineerChan Kim | Senior Software EngineerManaging Infrastructure as Code (IaC) across a massive organization comes with a unique set of security and logistical challenges, particularly when operating within a distributed, multi-repository architecture. At Pinterest, we designed the Resource Provisioner Pipeline (RPP), our specialized, proprietary Terraform execution engine to safely manage both critical and non-critical infrastructure changes.In this post, we will look under the hood of the first iteration of the RPP system. We will explore how it established compliance and provides robust security guardrails for our global AWS operations by utilizing dual c…

3 months, 2 weeks назад @ medium.com
Achieving Near-Linear Training Scalability for Pinterest’s Foundation Models
Achieving Near-Linear Training Scalability for Pinterest’s Foundation Models Achieving Near-Linear Training Scalability for Pinterest’s Foundation Models

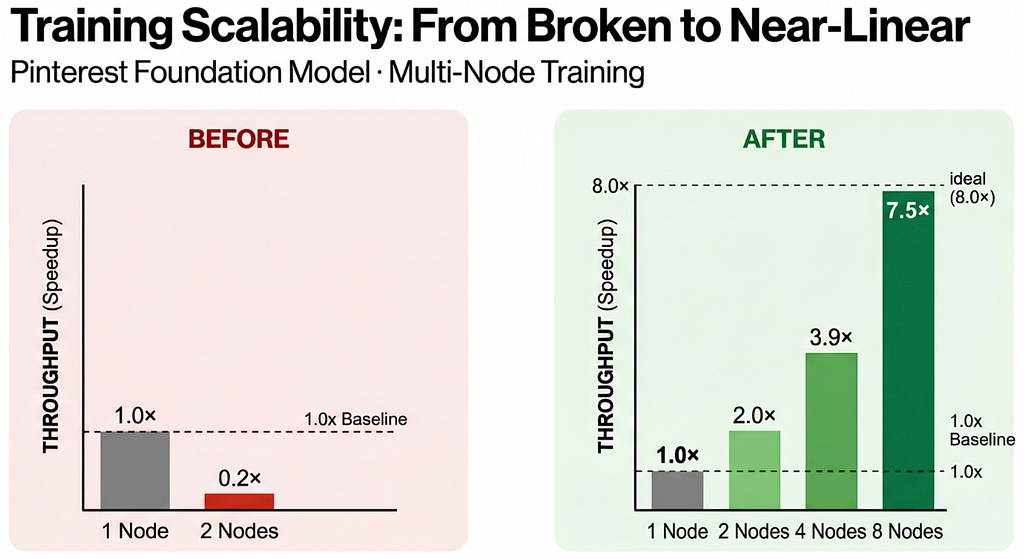
Sheng Huang | Software Engineer, AI Platform; Pong Eksombatchai | Machine Learning Engineer, Applied Sciences; Saurabh Vishwas Joshi | Software Engineer, AI Platform; Gaurav Arora | Software Engineer, AI Platform; Karthik Anantha Padmanabhan | Engineering Director, AI PlatformAt Pinterest, foundation models power recommendations for over 600 million monthly active users. Our latest Foundation Model (ACM RecSys 2025) pre-trains on two years of user activity data and is deployed into Home feed and Related Pins ranking, the platform’s two most important recommendation systems. Multi-node distributed training is the key to unlocking the next level of that capacity.¹But when we first attempted m…

4 months, 2 weeks назад @ medium.com
Automated Schema Evolution in Pinterest’s Next-Generation DB Ingestion Framework
Automated Schema Evolution in Pinterest’s Next-Generation DB Ingestion Framework Automated Schema Evolution in Pinterest’s Next-Generation DB Ingestion Framework

Yisheng Zhou | Software Engineer IILiang Mou | Sr Staff Software EngineerGabriel Raphael Garcia Montoya | Staff Software EngineerIstvan Podor | Staff Software EngineerIntroductionIn the first post of this series, we introduced Pinterest’s next-generation CDC-based ingestion platform built on Kafka, Flink, Spark, and Iceberg. In production, upstream schemas are constantly evolving, and in a distributed CDC pipeline, schema is not just metadata — it is a cross-system contract spanning ingestion, transformation, storage, and historical backfill. A schema change that is not handled carefully can break Flink jobs, block Spark upserts, or create inconsistencies between online and offline represen…

4 months, 2 weeks назад @ medium.com
Facebook
последний пост 6 days, 7 hours назад
F3 Lightning: How Meta Accelerates Ads ML Features to Production at Scale

Facebook Feature Framework (F3) is Meta’s framework for authoring, compiling, and serving the machine learning features underlying ads ranking models, where a single request can require more than 20,000 features. We first presented F3 at AI @ Scale 2020. F3 reduced execution computational costs by compiling all features into a single merged graph, but that [...]

Read More...

The post F3 Lightning: How Meta Accelerates Ads ML Features to Production at Scale appeared first on Engineering at Meta.

6 days, 7 hours назад @ engineering.fb.com
Catching Bugs Before They Land: JiTTesting’s Human-on-the-Loop Approach at Full Scale

Over the last year we’ve been sharing our work leveraging large language models to catch bugs on the fly — a novel approach we call Catching Just-in-Time Tests (JiTTests). Now, we’re sharing the results and positive impact we’ve seen with Catching JiTTests deployed into production. Our paper, “Just-in-Time Catching Test Generation at Meta,” fully details [...]

Read More...

The post Catching Bugs Before They Land: JiTTesting’s Human-on-the-Loop Approach at Full Scale appeared first on Engineering at Meta.

1 week, 4 days назад @ engineering.fb.com
Meta Andromeda: Powering the Next Generation of Ads Retrieval Through Model-System Co-Design

This post describes the next generation of Meta Andromeda, Meta’s personalized ads retrieval engine, and how co-designing the model, system, and GPU hardware unlocks a new efficiency frontier for ads retrieval. In production, the system scores every eligible ad with near ranking-level model performance at retrieval scale and surfaces the top candidates at over one [...]

Read More...

The post Meta Andromeda: Powering the Next Generation of Ads Retrieval Through Model-System Co-Design appeared first on Engineering at Meta.

1 week, 5 days назад @ engineering.fb.com
PrivacyLib: Privacy Controls at the Data Access Boundary

This latest deep dive into Meta’s Privacy Aware Infrastructure (PAI) takes a look at PrivacyLib. A privacy requirement must hold as data moves through Meta’s diverse data and processing systems. Historically, supporting a new requirement meant implementing the same enforcement logic separately in each system. PrivacyLib replaces this with a common library that runs inside [...]

Read More...

The post PrivacyLib: Privacy Controls at the Data Access Boundary appeared first on Engineering at Meta.

1 week, 6 days назад @ engineering.fb.com
Meta Networking at the 2026 OCP Global Summit: Open Innovation for Scale-Up, Scale-Out, and Scale-Across AI Networks

At the 2026 Open Compute Project (OCP) Global Summit, Meta shared the networking innovations that are directly supporting our latest AI models, including Muse Wonder and Muse Spark, and our gigawatt-scale Prometheus cluster. Highlights IcePack & IceCube: Meta’s first liquid-cooled network rack with 102.4T switch blades (128×800G, Broadcom Tomahawk 6C and NVIDIA Spectrum-6 variants), running [...]

Read More...

The post Meta Networking at the 2026 OCP Global Summit: Open Innovation for Scale-Up, Scale-Out, and Scale-Across AI Networks appeared first on Engineering at Meta.

2 weeks назад @ engineering.fb.com
GenRecs Tokenization: Transforming Ads Recommendation at Meta with Stable Model Vocabulary

Generative Recommenders (GenRecs) represent a paradigm shift from scoring every ad to reasoning about ad content and user preferences together in order to predict the best outcome for advertisers. Leveraging the world knowledge built into LLMs makes ad matching more intelligent and precise, compounding gains for advertisers. GenRecs Tokenization is the foundational data representation that [...]

Read More...

The post GenRecs Tokenization: Transforming Ads Recommendation at Meta with Stable Model Vocabulary appeared first on Engineering at Meta.

3 weeks назад @ engineering.fb.com
The Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Do

Sometimes, giving an AI agent all of the knowledge it needs is the wrong approach. At Meta, we’ve seen notable improvements in efficiency and accuracy by keeping the orchestration layer of our data pipeline agents deliberately thin: It routes work and enforces reliability checks, while specialized agents do the domain reasoning. We’re sharing our own [...]

Read More...

The post The Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Do appeared first on Engineering at Meta.

3 weeks назад @ engineering.fb.com
Inside Prometheus: Meta’s Journey to a Gigawatt-Scale Supercluster

With the recent release of the Muse family of foundational models, we want to take you inside the infrastructure that has made it all possible. The first phase of Prometheus, our gigawatt-scale supercluster, is already complete and we’re working toward scaling it to comprise ~1 million GPUs. Prometheus also features technologies like closed-loop liquid cooling [...]

Read More...

The post Inside Prometheus: Meta’s Journey to a Gigawatt-Scale Supercluster appeared first on Engineering at Meta.

3 weeks назад @ engineering.fb.com
How Meta Built Forum With AI-Native Engineering

Meta’s newest app, Forum, is for anyone who wants to go deeper into the conversations in their Facebook groups. To build Forum, Meta engineers adopted a whole new way of working by bringing an AI agent into the development cycle. We’re sharing insights into what it took to build Forum with agentic AI: how we [...]

Read More...

The post How Meta Built Forum With AI-Native Engineering appeared first on Engineering at Meta.

3 weeks, 4 days назад @ engineering.fb.com
Meta’s Generative Ads Model (GEM): Scaling the Central Model and Compute Engine for Frontier Ads AI

Last year, we introduced GEM, the industry’s largest recommendation system (RecSys) foundation model. GEM established Meta’s first LLM-inspired paradigm for ads recommendation, driving major performance gains. Building on this foundation, our next goal is to further scale both compute and intelligence transfer with next-generation hardware, and expand this capability across Meta’s entire ads ecosystem. This [...]

Read More...

The post Meta’s Generative Ads Model (GEM): Scaling the Central Model and Compute Engine for Frontier Ads AI appeared first on Engineering at Meta.

3 weeks, 6 days назад @ engineering.fb.com
OCP Summit 2026: Powering AI with Open Innovations in Scale-Up, Scale-Out, and Scale-Across Networks

At the 2026 Open Compute Project Global Summit, Meta is sharing the next generation of open networking infrastructure, including: Our first liquid-cooled network rack (IcePack), and 102.4T switch platform (IceCube). Flattened Planar Fabric (FPF), a multiplane backend scale-out fabric that fundamentally changes how GPUs connect to the network MetaRoCE, our open-source AI transport protocol. Launching [...]

Read More...

The post OCP Summit 2026: Powering AI with Open Innovations in Scale-Up, Scale-Out, and Scale-Across Networks appeared first on Engineering at Meta.

4 weeks назад @ engineering.fb.com
Turning Opportunistic AI Inference Capacity Into Better Ads Recommendations

At Meta, we’ve built a system that enhances ads recommendations by leveraging idle inference capacity in our fleet. Two elasticity levers in the system allow ads recommendation work to expand across opportunistic capacity, without compromising baseline performance. This post describes how we designed and now operate the system at Meta’s scale and how it drives [...]

Read More...

The post Turning Opportunistic AI Inference Capacity Into Better Ads Recommendations appeared first on Engineering at Meta.

4 weeks назад @ engineering.fb.com
An Organizational Second Brain: Building an AI That Learns From Experts

We’ve built an AI agent that acts as a secondary expert for a given domain, making deep specialist knowledge readily available and preserved for anyone in an organization to access, share, and build upon. This is not a typical domain-specific agent. Its novelty comes from integrating two layers: A structured, auditable knowledge architecture separates what [...]

Read More...

The post An Organizational Second Brain: Building an AI That Learns From Experts appeared first on Engineering at Meta.

2 months, 1 week назад @ engineering.fb.com
From User Sequences to Scaling Laws: A Multi-Stage Architecture for Meta’s Ads Ranking

Every day, Meta’s recommendation platforms handle billions of user interactions, generating rich temporal signals that capture individual preferences and intent across products, ads, and content. In our 2024 post on sequence learning for ads recommendations, we showed how modeling the order and timing of user actions (rather than relying on static, manually engineered sparse features) [...]

Read More...

The post From User Sequences to Scaling Laws: A Multi-Stage Architecture for Meta’s Ads Ranking appeared first on Engineering at Meta.

3 months назад @ engineering.fb.com
GEM Training: How Meta Doubled the Efficiency of Its LLM-Scale Ads Foundation Model

Meta’s Generative Ads Recommendation Model (GEM), the foundation model behind ads recommendations across Instagram and Facebook, now trains at LLM scale on several thousand of the latest-generation GPUs. This post goes into the details on how we achieved: doubling end-to-end (E2E) training efficiency to 20–25% Model FLOPs Utilization (MFU) while scaling training FLOPs 4x in [...]

Read More...

The post GEM Training: How Meta Doubled the Efficiency of Its LLM-Scale Ads Foundation Model appeared first on Engineering at Meta.

3 months, 1 week назад @ engineering.fb.com
Uber Engineering
последний пост None
Spotify Engineering Spotify Engineering
последний пост None
Ripple Engineering Ripple Engineering
последний пост None
Dmitry Anoshin recommends
Snowflake
последний пост None
Cloudera Cloudera
последний пост None
Smart Data
последний пост 2 days, 12 hours назад
How an Online MBA in Marketing Connects AI and Data Analytics

Graduate coursework links automated pattern detection to real budget decisions.

2 days, 12 hours назад @ smartdatacollective.com
Drone Technology as a Business Investment: Calculating ROI, Costs, and Long-Term Value

Calculate the real operational return of commercial UAV programs before building custom tools.

3 days, 6 hours назад @ smartdatacollective.com
Workforce Analytics for Auto Repair Shops: Reading Technician Productivity Weekly

Weekly repair order reviews catch bay bottlenecks and discount leaks before Friday.

5 days, 3 hours назад @ smartdatacollective.com
4 Best Self-Hosted Analytics Solutions

Run your own tracking stack without handing visitor data to third parties.

5 days, 19 hours назад @ smartdatacollective.com
How Data Professionals Optimize Devices for AI and ML Projects

Practical hardware, memory, and workflow habits for local machine learning.

6 days, 6 hours назад @ smartdatacollective.com
AI Lease Abstraction and Month-End Close Speed-Up Checklist

Validate lease terms at signing so close week focuses on real exceptions.

6 days, 9 hours назад @ smartdatacollective.com
Your Attribution Model Is Fine. Your CRM Is Lying to It

Audit duplicate contacts and decayed records before rebuilding your dashboards.

1 week назад @ smartdatacollective.com
Wikipedia Editing Services and AI Training Data: Why LLMs Still Treat Wikipedia as a Source of Truth

What the training papers establish, what current answers reveal, and how to request supported corrections.

1 week, 1 day назад @ smartdatacollective.com
How to Use an AI Avatar Generator to Run Measurable Video Experiments

Isolate one creative variable per test to measure what drives video performance.

1 week, 3 days назад @ smartdatacollective.com
What Business Intelligence Teams Can Learn from Lab Data Governance

Lab traceability gives BI teams a way to catch errors earlier.

1 week, 5 days назад @ smartdatacollective.com
How Businesses Can Use Workplace Data to Create Better Office Environments

Better office decisions begin with how people use the space.

3 weeks назад @ smartdatacollective.com
From AI Prototype to Production: Observability and Scalability Requirements for Data-Heavy SaaS Applications

A practical engineering checklist for reviewing generated code, testing data-heavy workflows and deciding what is ready to ship.

3 weeks, 4 days назад @ smartdatacollective.com
The Trouble With AI That Won’t Leave a Job Unfinished

What shutdown experiments reveal about AI agents that keep pursuing an unfinished task.

4 weeks, 1 day назад @ smartdatacollective.com
AI-Powered Logo Generation: Design.com vs Looka

Choose between Design.com and Looka with a clear view of logo files and licensing.

1 month назад @ smartdatacollective.com
Retailers Should Stop Treating Every Stockout as Equal

Retailers should rank stockouts by expected demand and margin at risk, not just how often shelves are empty.

1 month назад @ smartdatacollective.com
Knoldus
последний пост None
We Cloud Data We Cloud Data
последний пост 4 days, 9 hours назад
Why Managers Never Know Their Team’s Training Status (And What That Is Costing You)

Key Takeaways The End of Quarter Surprise An engineering manager conducts a quarterly performance review or investigates a missed milestone, only to discover the employee never completed the mandatory security protocol or AI tool onboarding module.This scenario plays out daily across mid-market enterprises. Managers typically find out about training gaps after they manifest as project […]

The post Why Managers Never Know Their Team’s Training Status (And What That Is Costing You) appeared first on WeCloudData.

4 days, 9 hours назад @ weclouddata.com
LinkedIn Learning vs. an LMS: What Growing Companies Get Wrong About the Difference

Key Takeaways Where upskilling programs might fall short? The scenario is playing out across hundreds of mid-sized companies this week. Your organization crosses the 150-employee threshold. Executive leadership announces a strategic imperative to upskill the workforce. HR or L&D responds by procuring a bulk license of LinkedIn Learning seats, sending out an enterprise-wide onboarding email, […]

The post LinkedIn Learning vs. an LMS: What Growing Companies Get Wrong About the Difference appeared first on WeCloudData.

1 week назад @ weclouddata.com
Your CEO Just Said “Build an AI-Ready Workforce.” Now what?

Key Takeaways Build an AI Ready Workforce? The email lands in your inbox on a Tuesday morning. Subject line: Strategic Priority: AI Transformation. Your CEO has just announced that artificial intelligence is now the company’s defining operational pillar. Everyone in the executive steering meeting nods along. Then, inevitably, all eyes turn toward the Learning & […]

The post Your CEO Just Said “Build an AI-Ready Workforce.” Now what? appeared first on WeCloudData.

1 week, 4 days назад @ weclouddata.com
How to Report AI Capability Development to your Board when your platform cannot give you the data

Key Takeaways Introduction Imagine this scenario: as the Chief Learning Officer (CLO) or Chief Information Officer (CIO) of a Canadian financial institution, you are called into the boardroom. The directors are seated, ready to evaluate the organization’s strategic roadmap. They ask you a simple question: “How ready is our workforce to safely deploy, monitor, and […]

The post How to Report AI Capability Development to your Board when your platform cannot give you the data appeared first on WeCloudData.

2 weeks назад @ weclouddata.com
The Real Cost of Managing Compliance Training in a Spreadsheet

Key Takeaways Time to rethink your current manual compliance system? Almost every organization has used a spreadsheet to track their compliance training at some point. It starts with an alluring vision of a practical solution. A simple spreadsheet document that can be used to store the employee’s name, certification dates, expiry dates and renewal deadlines. […]

The post The Real Cost of Managing Compliance Training in a Spreadsheet appeared first on WeCloudData.

2 weeks, 3 days назад @ weclouddata.com
Data Engineering for AI: Data Pipelines for Machine Learning and GenAI

Even the most sophisticated artificial intelligence model cannot consistently deliver meaningful results without reliable, relevant, and accessible data. In production environments, model performance is constrained by the quality and availability of the underlying data fed into it. Building enterprise-grade AI requires far more than collecting and storing raw data. Data must be collected from disparate […]

The post Data Engineering for AI: Data Pipelines for Machine Learning and GenAI appeared first on WeCloudData.

2 weeks, 3 days назад @ weclouddata.com
Why Employee Onboarding Breaks at 300 People

Key Takeaways What Bad Onboarding Looks like Imagine investing weeks recruiting and training a new employee only to have them leave before completing probation. Silent quitting is becoming more popular than ever and one of the reasons is bad onboarding. Onboarding can lose its effectiveness if a company grows too large e.g. if the headcount […]

The post Why Employee Onboarding Breaks at 300 People appeared first on WeCloudData.

2 weeks, 6 days назад @ weclouddata.com
What is AI Observability & How to Monitor AI Systems

Getting an AI application past the deployment phase is a major milestone, but going live is only the beginning of the system’s operational lifecycle. Traditional software development often operates under the assumption that if an application passes health checks, stays online, and returns standard success status codes, the system is healthy. For AI-driven systems, this […]

The post What is AI Observability & How to Monitor AI Systems appeared first on WeCloudData.

3 weeks, 3 days назад @ weclouddata.com
What is AI Observability & How to Monitor AI Systems

Getting an AI application past the deployment phase is a major milestone, but going live is only the beginning of the system’s operational lifecycle. Traditional software development often operates under the assumption that if an application passes health checks, stays online, and returns standard success status codes, the system is healthy. For AI-driven systems, this […]

The post What is AI Observability & How to Monitor AI Systems appeared first on WeCloudData.

3 weeks, 4 days назад @ weclouddata.com
Cloud for AI: How Cloud Infrastructure Powers Modern AI Applications

An AI model can be technically impressive in a test environment, but bringing AI into production requires a robust infrastructure capable of supporting data, compute, storage, networking, APIs, deployment, scaling, monitoring, and security. AI capability depends not only on the model itself, but also on the infrastructure that runs it. While MLOps helps operationalize machine […]

The post Cloud for AI: How Cloud Infrastructure Powers Modern AI Applications appeared first on WeCloudData.

1 month назад @ weclouddata.com
Cloud for AI: How Cloud Infrastructure Powers Modern AI Applications

An AI model can be technically impressive in a test environment, but bringing AI into production requires a robust infrastructure capable of supporting data, compute, storage, networking, APIs, deployment, scaling, monitoring, and security. AI capability depends not only on the model itself, but also on the infrastructure that runs it. While MLOps helps operationalize machine […]

The post Cloud for AI: How Cloud Infrastructure Powers Modern AI Applications appeared first on WeCloudData.

1 month назад @ weclouddata.com
Cloud for AI
Cloud for AI

An AI model can be technically impressive in a test environment, but bringing AI into production requires a robust infrastructure capable of supporting data, compute, storage, networking, APIs, deployment, scaling, monitoring, and security. AI capability depends not only on the model itself, but also on the infrastructure that runs it. While MLOps helps operationalize machine […]

The post Cloud for AI appeared first on WeCloudData.

1 month назад @ weclouddata.com
MLOps Explained
MLOps Explained

Moving an AI system from a prototype to a live product is rarely smooth. A data scientist can build a model inside a Jupyter notebook that boasts 95% accuracy, but getting that code to run reliably in a live production environment is a whole different ballgame. Once real users start interacting with a model, a […]

The post MLOps Explained appeared first on WeCloudData.

1 month, 1 week назад @ weclouddata.com
How to Move AI From Prototype to Production

Following the insights from LEAP 2026, AI has officially moved beyond the realm of experimentation. Organizations are no longer asking whether AI works; they are asking a much harder, operational question: How do we actually put AI into production? A prototype can demonstrate that a concept is possible in a controlled environment. However, production-ready AI […]

The post How to Move AI From Prototype to Production appeared first on WeCloudData.

1 month, 2 weeks назад @ weclouddata.com
LEAP 2026: Inside Saudi Arabia’s AI Future

For four days in Riyadh, thousands of technology leaders, investors, startups, government organizations, and innovators gathered around a question that is becoming increasingly difficult for businesses to ignore: What does it actually take to turn AI ambition into real-world impact? That question was at the heart of LEAP 2026, held in Riyadh from August 31 […]

The post LEAP 2026: Inside Saudi Arabia’s AI Future appeared first on WeCloudData.

1 month, 3 weeks назад @ weclouddata.com
Learn Data Engineering
последний пост None
SCRIBD
последний пост 4 months назад
Stop Building Models. Start Building Systems.
Stop Building Models. Start Building Systems. Stop Building Models. Start Building Systems.

LLM models change. Prompt quality changes. Cost changes. We assumed that from day one.

So instead of building a one-off system tied to a specific model or a single “perfect prompt,” we focused on a repeatable process that we successfully applied to two large-scale projects (Slideshare and Scribd). That repeatable process is what we’re sharing. What We Achieved

This process enabled projects that normally require far more people and time: Slideshare: scanned tens of millions of slideshows, classifying each against adult-related content categories (e.g., sexually explicit content, drugs, alcohol, tobacco) and flagging the small fraction that matched.

Scribd: scanned hundreds of millions of doc…

4 months назад @ tech.scribd.com
Dual-Embedding Trust Scoring
Dual-Embedding Trust Scoring Dual-Embedding Trust Scoring

Scribd is a digital library serving academics and lifelong learners, offering hundreds of millions of documents. This very nature presents a significant concern: content trust and safety. Protecting our library from undesirable and unsafe content is a top priority, but the multilingual and multimodal (text and images) nature of our platform makes this mission very challenging. Also, while third-party tools exist, they often fall short, lacking the nuance to handle our specific trust and safety categories.

To this end, we capitalized on Generative AI (GenAI) signals and our proprietary multilingual embeddings, in conjunction with classical machine learning methods, to develop our Content Tru…

8 months, 2 weeks назад @ tech.scribd.com
Screaming in the Cloud

Scribd has absolutely fascinating data-at-scale type problems, all the way

down to the fundamentals of how we use AWS S3. In my previous

post I wrote about the design of Content

Crush and how Scribd is consolidating objects in S3 to minimize our costs.

Related to that work I was fortunate enough to join the (in)famous Corey

Quinn to talk about Engineering around Extreme S3 scale:

Checking if files are damaged? $100K. Using newer S3 tools? Way too expensive.

Normal solutions don’t work anymore. Tyler shares how with this much data, you

can’t just throw money at the problem, but rather you have to engineer your way

out.

You can also listen

On Everand

or watch via the Last Week in AWS YouTube …

9 months назад @ tech.scribd.com
Deploying a Cost-Effective, Scalable PhotoDNA System for CSAM Detection
Deploying a Cost-Effective, Scalable PhotoDNA System for CSAM Detection Deploying a Cost-Effective, Scalable PhotoDNA System for CSAM Detection

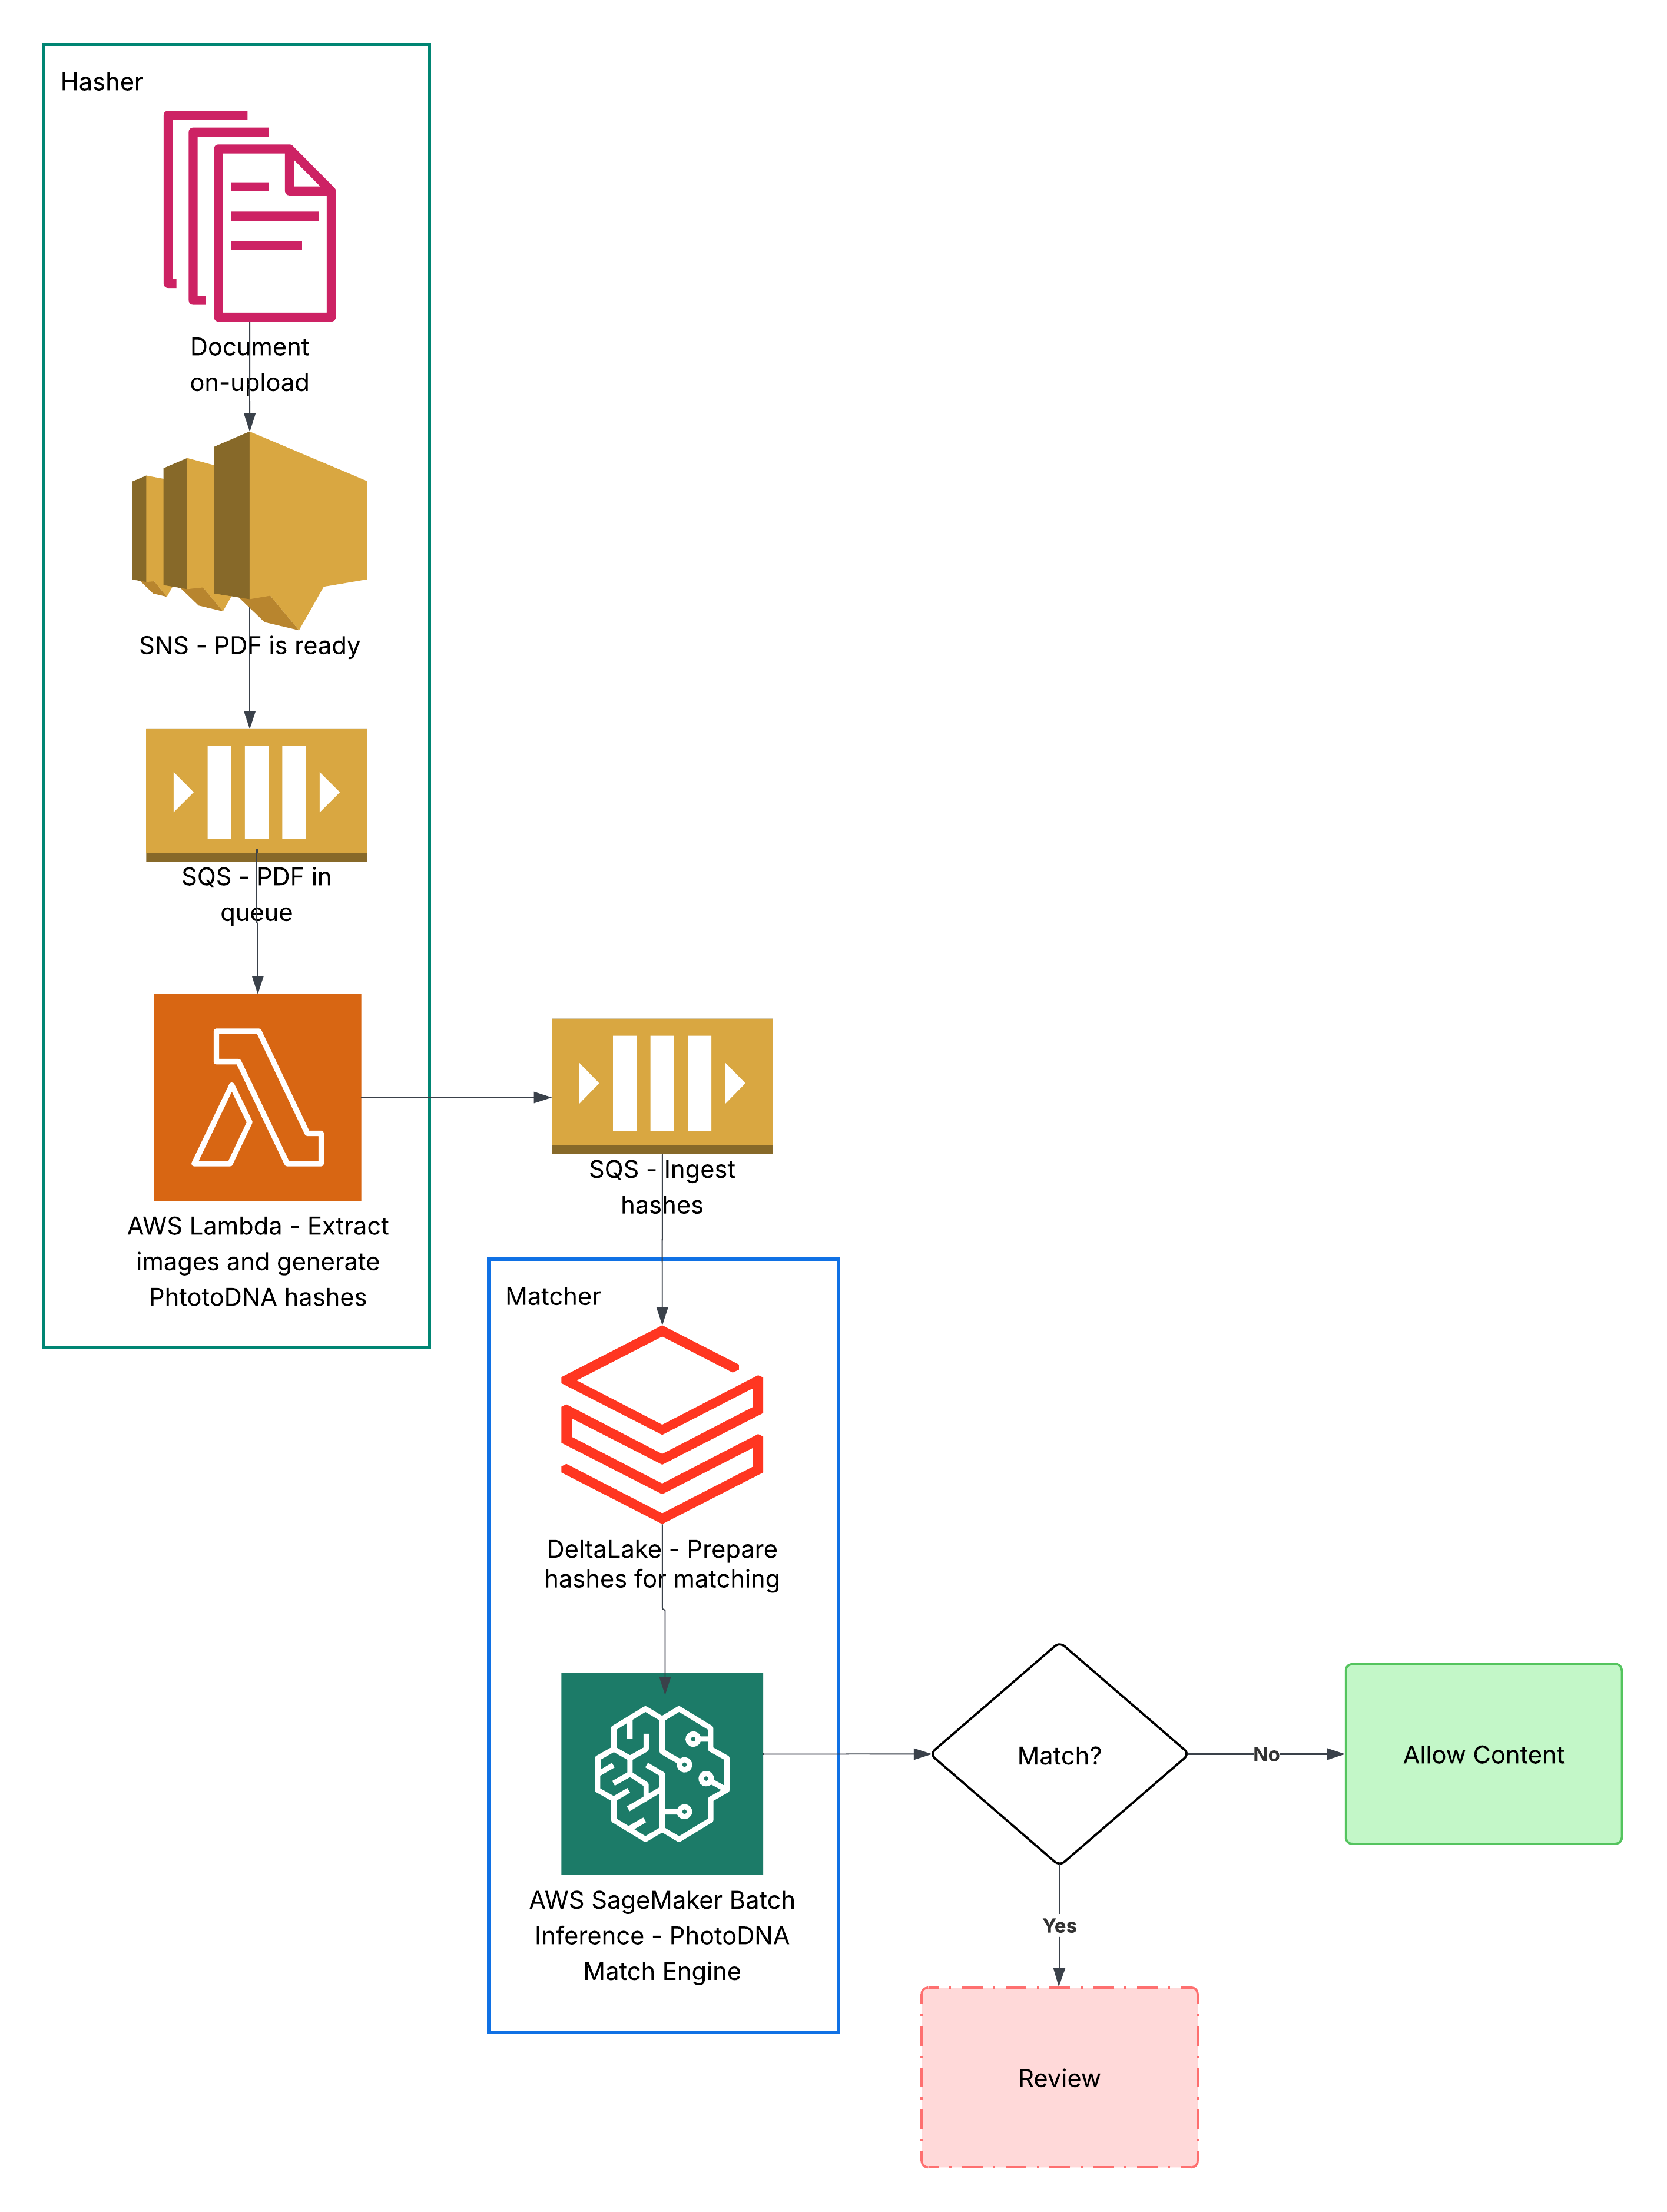
Child safety is a non‑negotiable responsibility for any platform that hosts user‑generated content. Over the last year, we designed and deployed a production system that detects known Child Sexual Abuse Material (CSAM) using PhotoDNA perceptual hashes, integrates with the National Center for Missing and Exploted Children’s (NCMEC) reporting system, and scales efficiently across our ingestion surfaces. This post explains the problem we set out to solve, how PhotoDNA hashing works, the online child-protection ecosystem (NCMEC, Tech Coalition, Project Lantern), our architecture and operational model, cost considerations, and key learnings.

Note: This article discusses safety technology at a hi…

9 months, 3 weeks назад @ tech.scribd.com
Jesse Anderson Jesse Anderson
последний пост None
Data Quest
последний пост None
Infrastructure
AWS
последний пост 59 минут назад
Automate ETL pipeline creation with Amazon Bedrock AgentCore and AWS Glue

Agentic Data Ingestion is an open-source solution that uses AI agents on Amazon Bedrock to automate data pipeline creation, from file upload to queryable tables. Point it at a file or database table, and foundation models propose the field mapping, generate and test the AWS Glue transform, and run the job behind human approval gates.

59 минут назад @ aws.amazon.com
Introducing the Workday Data Cloud integration with AWS

Workday Data Cloud now integrates with AWS, giving developers bi-directional, zero-copy access to Workday's governed people and money data from the AWS analytics and AI services they already use, without brittle pipelines or data duplication.

1 час назад @ aws.amazon.com
Define metrics once and keep them correct with the dbt Semantic Layer on Amazon Redshift

Amazon Redshift has no native semantic layer, yet teams still need consistent, governed metric definitions across BI tools. This post shows how to define a metric once with the open-source dbt Semantic Layer (MetricFlow) on Amazon Redshift so it stays correct at any grain, and proves a non-additive weekly average comes out right ($280, not $550).

3 часа назад @ aws.amazon.com
Single-shot and agentic retrieval with Amazon Bedrock Managed Knowledge Base

Amazon Bedrock Managed Knowledge Base now supports single-shot RAG and retrieval-only requests through AgenticRetrieveStream, alongside agentic retrieval. This post explains how the maxAgentIteration parameter matches retrieval effort to each request, using an illustrative internal banking policy assistant.

4 часа назад @ aws.amazon.com
Assess and track your Amazon Redshift RA3 to RG modernization with CUDOS

The CUDOS 5.10 dashboard adds an Amazon Redshift RA3-to-RG section that helps you assess the cost-efficiency opportunity of moving to Graviton-based RG instances, track adoption as your instance-generation mix shifts, and quantify the gains already achieved on RG.

4 часа назад @ aws.amazon.com
Introducing Claude Fable 5.2 on AWS

Claude Fable 5.2 and Claude Mythos 5.2 are now available on Amazon Bedrock and Claude Platform on AWS. Learn what's new in both models, why Fable 5.2 matters for your technical workloads, and how to get started building with it on Amazon Bedrock.

4 часа назад @ aws.amazon.com
NVIDIA Nemotron 3.5 Super VL is now available in Amazon SageMaker JumpStart

NVIDIA Nemotron 3.5 Super VL, a 120B-parameter multimodal vision-language model, is now available in Amazon SageMaker JumpStart. Deploy the NVFP4 or BF16 variant in a few steps, then run text, image, and video inference for document intelligence, computer-use agents, and multimodal agentic workloads.

4 часа назад @ aws.amazon.com
Pluggable Agentic AI Framework: A seven-layer composable enterprise agentic AI reference architecture on Amazon Bedrock AgentCore

A seven-layer composable reference architecture for taking enterprise agentic AI from prototype to production on Amazon Bedrock AgentCore. Each layer has a stable contract, so you can swap technologies at any layer without redesigning the rest of the stack.

5 часов назад @ aws.amazon.com
How CrossnoKaye grounds physical AI with Amazon Bedrock AgentCore

CrossnoKaye brought physical AI to heavy industry with Amazon Bedrock AgentCore. Its ATLAS platform and AURA agentic system ground AI reasoning in live plant data and run verifiable Python in isolated AgentCore sandboxes, giving plant engineers checkable, math-backed answers instead of model guesses.

5 часов назад @ aws.amazon.com
Professional work deserves professional tools. Meet AWS Quick.

Introducing AWS Quick, formerly Amazon Quick, and the debut of our first brand campaign celebrating teams who keep business moving. AWS Quick is the AI workspace built only for work, where teams use AI agents to research, analyze, and act across the data and applications they already rely on.

5 часов назад @ aws.amazon.com
Amazon Athena introduces system tables for query execution observability

Amazon Athena now offers system tables: SQL-queryable, per-query execution metadata stored as Apache Iceberg in your own account. This post walks through what system tables are, how to turn them on, and how to use them for usage analysis, cost attribution, performance trends, audit, and capacity optimization without custom pipelines.

6 часов назад @ aws.amazon.com
Topstep’s migration journey: Self-managed Redis OSS to Amazon ElastiCache for Valkey

Topstep migrated roughly 53 million keys from self-managed Redis OSS to a fully managed, Multi-AZ Amazon ElastiCache for Valkey cluster. Using RedisShake and a single Amazon Route 53 DNS change, the team completed a blue/green cutover in seconds with no application code changes beyond a small TLS configuration update.

7 часов назад @ aws.amazon.com
Store and process large strings in Amazon Redshift SUPER columns

Storing large semi-structured data such as JSON and arrays in a data warehouse often means splitting or truncating your data. With PartiQL and the SUPER data type, Amazon Redshift is now equipped to handle these issues. In this post, we walk you through three key SUPER data type enhancements that simplify semi-structured data workflows and reduce common migration challenges.

3 days, 3 hours назад @ aws.amazon.com
Your Guide to the Developer Tools Track at AWS re:Invent 2026

AWS re:Invent 2026 is almost here, and if you’re a developer, the Developer Tools (DVT) track is where you’ll want to spend your week. This year is all about agentic development, from multi-agent workflows to autonomous agents that keep working while you sleep. And CI/CD, Infrastructure as Code, and full-stack development are still well represented. […]

3 days, 5 hours назад @ aws.amazon.com
Run Maestro tests on real Android devices using AWS Device Farm

Learn how ManoMano runs Maestro mobile UI tests on real Android devices using the AWS Device Farm custom test environment. This post covers packaging your YAML flows, configuring the test spec, installing the Maestro CLI, handling manufacturer-specific device restrictions, and automating the workflow in your CI/CD pipeline.

3 days, 6 hours назад @ aws.amazon.com
AWS
последний пост 59 минут назад
SageMaker Inference now supports Multi-Instance GPU to maximize GPU utilization for model endpoints

Amazon SageMaker Inference now supports GPU partitioning with NVIDIA Multi-Instance GPU (MIG), which divides one GPU into hardware-isolated partitions so you can run a different model in each or take a right-sized fraction of a newer accelerator. This post shows how two optional API fields place one model per partition, and what we measured against a whole older GPU.

3 days, 6 hours назад @ aws.amazon.com
Taxonomy of agentic primitives in Amazon Quick

As we built Amazon Quick, its agents grew from answering questions to taking actions, and the same primitives kept getting rebuilt under different names. This post shares the taxonomy we converged on — triggers, agents, capabilities, and learned context — found by decomposing agentic work into four plain questions: When, What, Who, and How.

3 days, 6 hours назад @ aws.amazon.com
Serverless MCP server for AI agent data lake access on Amazon ECS Fargate

Learn how to build a serverless Model Context Protocol (MCP) server on Amazon ECS with AWS Fargate that gives AI agents secure, metadata-driven access to an enterprise data lake. Exposing a new dataset requires only a JSON file, with no per-dataset integration code.

3 days, 7 hours назад @ aws.amazon.com
Govern AI agent access with Okta Cross App Access and Amazon Bedrock AgentCore – Part 2

In Part 1 you built one governed agent. Part 2 scales the pattern to an enterprise: Amazon Bedrock AgentCore Gateway becomes the single front door and redeems Okta's grant, Cedar policies bind each tool to the agent, a second agent runs on Amazon EKS, and AgentCore Observability traces every allow and deny beside Okta's log in Amazon CloudWatch.

3 days, 7 hours назад @ aws.amazon.com
Govern AI agent access with Okta Cross App Access and Amazon Bedrock AgentCore – Part 1

An AI agent that acts for a user raises an identity question that per-app OAuth and service accounts leave open: which agent may act for which user, and how you stop it. In this first post of two, you build a task agent on Amazon Bedrock AgentCore that governs access through Okta Cross App Access and AgentCore Identity, and enforces each user's authority.

3 days, 7 hours назад @ aws.amazon.com
How Greenlight Financial built an autonomous SOC solution on Amazon Bedrock AgentCore

Greenlight Financial resolves more than 90% of up to 4,000 monthly security and risk cases without human intervention using Luna, a tiered multi-agent system on Amazon Bedrock AgentCore. This post covers the architecture, episodic memory for continuous learning, and the expansion from SOC operations into financial risk triage.

3 days, 7 hours назад @ aws.amazon.com
Taxbit Assist: A grounded, role-aware AI agent on Amazon Bedrock AgentCore

Taxbit built Taxbit Assist, a cited, permission-aware AI assistant embedded in its enterprise dashboard, on Amazon Bedrock AgentCore. This post shows how they grounded answers in a curated knowledge base, enforced role-aware and region-compliant safety, and continuously measured answer quality on live production traffic.

3 days, 7 hours назад @ aws.amazon.com
Extend Claude Code to remote sessions on Amazon Bedrock AgentCore with security controls

Run Claude Code as a remote agent on Amazon Bedrock AgentCore. Each coding task runs in its own isolated session in your AWS account, every model call goes through Amazon Bedrock, and the result comes back as a GitHub pull request you review and merge.

3 days, 7 hours назад @ aws.amazon.com
Getting started with Web Answer on Amazon Bedrock AgentCore

Web Answer on Amazon Bedrock AgentCore returns a synthesized, source-cited answer to a natural-language question in a single tool call, with no search, retrieve, synthesize, and citation pipeline to build. Learn how it works and how to add it to an AgentCore Gateway and call it from an agent.

4 days, 3 hours назад @ aws.amazon.com
Introducing bulk put items for Amazon DynamoDB: Load data from Amazon S3 into existing tables at scale

Bulk put items is a fully managed feature that loads data from Amazon S3 directly into your existing Amazon DynamoDB tables, with no impact to your table's read and write performance and at a lower price point than per-request writes. This post introduces the feature, walks through running an import end to end, and shares best practices for production.

4 days, 4 hours назад @ aws.amazon.com
How Amazon Marketplace evaluates content quality with Amazon SageMaker AI

Learn how Amazon Marketplace evaluates A+ Content quality at scale on Amazon SageMaker AI by rendering each product page as a single snapshot, scoring it with a vision-language model fused with OCR readability signals in a CatBoost classifier, and using SHAP to turn each decision into prioritized, actionable recommendations for selling partners.

4 days, 6 hours назад @ aws.amazon.com
Deliver multi-tenant AI analytics at scale with AgentCore and Lake Formation

Governed, multi-tenant data access is a key requirement for SaaS and B2C products that embed AI-powered analytics. This post shows how to combine Amazon Cognito and AWS Lake Formation on Amazon Bedrock AgentCore to enforce row- and column-level data access for external users, with a minimal-privilege Lambda acting as a credential broker.

4 days, 9 hours назад @ aws.amazon.com
Use decision models with Amazon Bedrock AgentCore Evaluations

Some agent-evaluation questions are narrow and repeatable, and decision models answer exactly that kind of question. This post shows how to connect two decision models, Jev and Strands Decider, to Amazon Bedrock AgentCore Evaluations through code-based evaluators, and how to validate a decision-model check before you gate a release on it.

5 days, 5 hours назад @ aws.amazon.com
Smart Approvals in Amazon Quick: Human oversight where it matters

Smart Approvals in Amazon Quick reviews eligible agent actions within your existing controls, reducing unnecessary approval prompts while keeping consequential decisions with a person. See how policy sets the boundary, how a classifier reviews actions, and how AWS CloudTrail and Amazon CloudWatch Logs support audit.

5 days, 7 hours назад @ aws.amazon.com
Four layers of context engineering for production AI agents: How Deep Insight applies them in working code

In production AI agents, context management is the real bottleneck. This post presents a four-layer context engineering framework (architecture, prompts, file-based tools, and verification agents), implemented in working code from Deep Insight, an open source multi-agent data analysis solution on the Strands Agents SDK and Amazon Bedrock AgentCore.

5 days, 7 hours назад @ aws.amazon.com
Astronomer Astronomer
последний пост None
DBT — Data Build Tool DBT — Data Build Tool
последний пост None
FiveTran FiveTran
последний пост None
DataBricks
последний пост None
Mix
/r/DataEngineering
последний пост 11 часов назад
Hotfix in Dataform
Hotfix in Dataform

Hi, I'm close to releasing our Dataform branching and release process, but I'm unsure about the hotfix approach. Current setup: Dataform's default branch is main, so every workspace is cut from main and developers PR back to main. Each sprint, we cut a release branch from main, run final tests, and create a GitHub release, which updates the Dataform release config with the new tag. Current hotfix flow: Devs PR to main with a "hotfix" label. On merge, automation cuts a branch from the latest release branch, cherry-picks the hotfix commits, and opens a PR to the release branch. Someone then cuts a new release. The problem: The hotfix is made against main but cherry-picked onto the release bra…

11 часов назад @ reddit.com
Advice on keeping a job

Hey all, so, I have been doing this for about 6 years now on a legacy on-prem stack. Every time I try to transition to something more modern - dlt/dbt I get shot down. Stick to .NET, that's what the company wants. I try to introduce metadata importing, and no time for that, just stick to what you have. Well, I finally got what I want. We're moving to the cloud. Only it's been decided we don't have enough python/pyspark background, so someone else is writing an engine for us. I have been told I am going from owning the entire pipeline to only owning bronze/silver and the BAs will own gold. And Bronze/Silver will be automated. The best I get is to tweak some yaml files. Anything related to ac…

18 часов назад @ reddit.com
Need scheduled, parameterized reports (Excel/PDF/CSV) on Azure SQL + Power BI Pro. Where should I spend?

Current setup Azure SQL Database (Standard S2, DTU model). No linked servers or cross-database queries. Power BI Pro for dashboards (40 users, 3 authors). We have no tool for scheduled or paginated reports, and no SQL Server licenses or Fabric capacity. What we need Automated Excel, PDF and delimited-text (CSV/pipe/tab) reports Delivery by email and to a network share drive (SFTP would be a bonus, but we can move files with external processes) Parameterized subscriptions, with a large list of them managed from a table, like SSRS data-driven subscriptions About [N] reports and [N] recipients, mostly monthly Background At past jobs we used SSRS or Crystal Reports, and SSRS would fit. But SQL …

1 day, 19 hours назад @ reddit.com
I built loom-dbt: an author-time CLI to define model shapes once, generate them at scale, and search for what already exists before building something new.

I've been a big fan of DBT since picking it up a few years ago, but there's always been a few nuances at Enterprise scale that I felt detracted from the wizardry it unlocks. Simple things like discovery (does this already exist), duplication for similarly-shaped models, remembering to include appropriate tests (e.g. primary key uniqueness), MSP-angosticity, and rebuilding standard warehouse paradigms are things that I always found myself thinking "surely someone has already solved this". When I looked, I found some great point solutions but none that I felt had a big-picture lens. Loom-dbt (PyPI, GitHub) is my approach to solving these bugbears. It's a standalone CLI utility that: Enables t…

1 day, 21 hours назад @ reddit.com
Need advise
Need advise

My org has only OLTP, we are pulling data from it directly to powerbi and building facts and dims in semantic model. Now my org is thinking about creating datamarts for each department since there are so many requests for adhoc reports and proposed to do it in traditional way like creating new star schema based data marts and using azure etl tools to pull data from oltp but Im not familiar in building them so i proposed fabric since everything comes in fabric and they can use copilot to build their adhoc reports based on semantic model These are my questions Which way is better, answer it assuming i have only theoretical knowledge not practical experience Which one is cheaper and why Which …

2 days, 4 hours назад @ reddit.com
How to keep Models Synced

So at work I’m using Azure Pipelines as an orchestrator to materialize several tables in parallel. Each one is running a Create Table As Select sql statement and uses a DBT merge strategy so that each of them are incremental. My concern is that I can’t control for these jobs to run at the exact same time. Table X might start its job at 10:01. And Table Y might start at 10:03 and even a difference of a few seconds could mean that the source (which is Postgres) is not the exact same for both tables. submitted by /u/Delicious_Leader_785 [link] [comments]

2 days, 4 hours назад @ reddit.com
Ducklake in prod
Ducklake in prod

My fellow data wranglers, Has anyone built a real production solution using DuckLake? I mean something with an ELT pipeline and actual users, that would have sid ducklake as a component? submitted by /u/Dry-Aioli-6138 [link] [comments]

2 days, 10 hours назад @ reddit.com
Thoughts on McKinsey QuantumBlack?

I have been offered a position as a Junior Data Engineer at QB. The problem is that I don't really know too much about their reputation and if I would gain experiences and skills that would transfer well to BigTech/FAANG (which is my end goal). I worked at a couple of non-technical consultancies prior to my career change and they all involved boring work like making decks, communicating with clients, drafting proposals etc. The pay is good but the hours make me second guess myself. I think the typical advice is to avoid consultancies and aim for product tech companies where you are involved with systems throughout its lifecycle. I think the image in my head when I hear 'tech consultancy' is…

3 days, 4 hours назад @ reddit.com
What to send your boss before the next AI project
What to send your boss before the next AI project What to send your boss before the next AI project

submitted by /u/Charlotte1309 [link] [comments]

3 days, 8 hours назад @ reddit.com
What are you using to ingest/search/scan code from internal repos?

hey everyone! I have about a few TB worth of code repository data (from git-client compatible source control) and I need to be able to run recurrent scans on the code itself (not on the repo metadata, issues, commits or anything like that). The repositories are getting a steady stream of updates - some more than the others so there has to be some type of constant sync/re-scan. What I am looking for is * detecting projects that import a certain library version (for dependabot style functionality to bump something if a security issue arises or if there is some other issue) across all possible branches * detecting projects/code files that import a certain function from a library or implement a…

4 days, 1 hour назад @ reddit.com
Fabric vs Snowflake/Databricks

Not a troll post but an honest question, and maybe more about Microsoft vs Snowflake/Databricks. Why is Fabric so far behind its competitors. Not so much from the perspective of specific UI/UX or functionality, but more of a question of why MS engineers are seemingly incapable of just copying and improving on their competitors. Is it something about MS culture or competency? It seems like they should have enough money to hire talent if they wanted to, but everything from the UI to the bugginess of Fabric seems to scream no-budget startup cutting corners at every step to push garbage out the door. Are the dev and UI teams just that much worse? submitted by /u/Gawgba [link] [comments]

4 days, 5 hours назад @ reddit.com
What is the best project you've ever built?

Hey everyone, I'm asking about the best data engineering projects you've built. What are the details, architecture, and the repo links so we can see new ideas and learn from them? submitted by /u/FirefighterSilver879 [link] [comments]

4 days, 15 hours назад @ reddit.com
Not-so-beginner wanting to independently build ETL infrastructure but don't know where to look for material (100-1000 sources) to use.

The title. I want to work on things like schema drift across sources, entity resolution, warehousing, fetching, idempotence, checkpointing and transaction management. I have already had practice with most of these ideas, but they have been primitive things. I know how to log, I know how to store to Postgres, but I dont have experience with a stack. I have considered finding my own relationships between sources, but I have yet to discover a concrete avenue for handling volume. Other than that, I don't know what else to use. I want to make something real without paying, as much as I can. Thanks <3 submitted by /u/Usual_Macaroon7881 [link] [comments]

4 days, 21 hours назад @ reddit.com
NVIDIA released Auto-Ontology, that do you think?

NVIDIA open source a way to automatically create an ontology layer and let agents to understand enterprise data, here is the link is open source, what do you think ? https://github.com/NVIDIA/auto-ontology submitted by /u/No-Employer8282 [link] [comments]

5 days назад @ reddit.com
Data Engineer Niche tech Stack?

Hey DE super heroes, Let's help each other. What are the niche tech stacks/skills you are coming across in the Job Description and what we can learn? According to my knowledge - Python, Pyspark, sql = Mandatory Snowflake, dbt, ADF, Databricks= I am seeing in most of the JD. Now, it's your turn. 8+ YOE in the DE world 🌎 submitted by /u/Typical-Presence5628 [link] [comments]

5 days, 4 hours назад @ reddit.com
Towards Data Science
последний пост 7 часов назад
Continuous Batching Beats Static and Dynamic by Up to 2.91× in vLLM

For anyone running an inference server: a zero-variance control, five traffic traces, and an engine-vs-scheduler split show where the gains come from.

The post Continuous Batching Beats Static and Dynamic by Up to 2.91× in vLLM appeared first on Towards Data Science.

7 часов назад @ towardsdatascience.com
Ask AI to Refine Your Ideas, Not Invent Them

Studies of short stories, metaphors, and 486 participants point one way, an 800-person experiment points the other, and the author weighs both.

The post Ask AI to Refine Your Ideas, Not Invent Them appeared first on Towards Data Science.

9 часов назад @ towardsdatascience.com
How to Estimate the Recall of AI Agents with Capture-Recapture

A fisheries estimator from the 1890s, tested on 294 CUAD contracts, landed within 2 points of true recall for most agents with a 10% hand audit.

The post How to Estimate the Recall of AI Agents with Capture-Recapture appeared first on Towards Data Science.

10 часов назад @ towardsdatascience.com
Quantile Regression Caught the House Price OLS Missed by $55K

On 88 house sales, OLS predicted $164K for a $219K home, while a 90% interval from 5th and 95th percentile models spanned $136K to $227K.

The post Quantile Regression Caught the House Price OLS Missed by $55K appeared first on Towards Data Science.

12 часов назад @ towardsdatascience.com
How to Build Multi-Agent Systems with the OpenAI Agents SDK

Build an EV purchase adviser and a support agent in Python, then see how fan-out, pipelines, hierarchies, and swarms reuse the same building blocks.

The post How to Build Multi-Agent Systems with the OpenAI Agents SDK appeared first on Towards Data Science.

1 day, 9 hours назад @ towardsdatascience.com
Change One Monty Hall Rule and Five LLMs Still Say Switch

Even with step-by-step reasoning, the models landed near 33% accuracy, and one quoted the host's rule correctly before ignoring it.

The post Change One Monty Hall Rule and Five LLMs Still Say Switch appeared first on Towards Data Science.

1 day, 11 hours назад @ towardsdatascience.com
Timestral, t0, Tabby, and Morpheus-2.0 Compared on GIFT-Eval

All four time-series foundation models scale, patch, and predict quantiles; the real split is how series share information.

The post Timestral, t0, Tabby, and Morpheus-2.0 Compared on GIFT-Eval appeared first on Towards Data Science.

2 days, 9 hours назад @ towardsdatascience.com
How to Prioritize Product Feedback by Revenue at Risk

Bellwether joins support tickets, store reviews, sales calls, and NPS to CRM accounts, then stress-tests the ranking on 6,693 synthetic signals.

The post How to Prioritize Product Feedback by Revenue at Risk appeared first on Towards Data Science.

2 days, 11 hours назад @ towardsdatascience.com
How to Measure AI Adoption, Performance, and ROI With 12 KPIs

Includes a worked example with 50 users and $110,000 in first-year cost, plus baselines, targets, and ownership rules for every AI initiative.

The post How to Measure AI Adoption, Performance, and ROI With 12 KPIs appeared first on Towards Data Science.

3 days, 7 hours назад @ towardsdatascience.com
How to Manage Python Environments with uv Instead of venv and pip

A side-by-side walkthrough of venv plus pip and uv init, uv add, uv run, and uv sync, with a lockfile that recreates the project on another machine.

The post How to Manage Python Environments with uv Instead of venv and pip appeared first on Towards Data Science.

3 days, 9 hours назад @ towardsdatascience.com
Build Your First Multi-Tool AI Agent with Ollama and Python

AI Agents for Beginners, Part 2: The agent picks between three database tools, uses each result to choose its next call, and stops at an eight-turn circuit-breaker if it gets stuck.

The post Build Your First Multi-Tool AI Agent with Ollama and Python appeared first on Towards Data Science.

3 days, 10 hours назад @ towardsdatascience.com
Give Your Python AI Agent Persistent Memory with One JSON File

Three Python classes, an OpenRouter key, and gpt-4.1-mini give the agent a calculator, a stub web search, and conversation recall that survives restarts.

The post Give Your Python AI Agent Persistent Memory with One JSON File appeared first on Towards Data Science.

3 days, 12 hours назад @ towardsdatascience.com
How to Report for 100+ Clients With One Semantic Model

Configuration-driven reporting: one semantic model, one metric catalog, and a few lines of configuration per audience

The post How to Report for 100+ Clients With One Semantic Model appeared first on Towards Data Science.

4 days, 7 hours назад @ towardsdatascience.com
How We Built NASA's Zero-Shot Detector for Gas Leaks from Space

We trained one model on methane. Without retraining, it also maps carbon monoxide, ammonia and nitrogen dioxide plumes, including the first automated CO detections from NASA’s EMIT.

The post How We Built NASA's Zero-Shot Detector for Gas Leaks from Space appeared first on Towards Data Science.

4 days, 9 hours назад @ towardsdatascience.com
How GEO, WebMCP, and Bot Paywalls Are Building the AI-Native Internet

The internet of the future will look much different than the one today. Businesses are already transitioning.

The post How GEO, WebMCP, and Bot Paywalls Are Building the AI-Native Internet appeared first on Towards Data Science.

4 days, 10 hours назад @ towardsdatascience.com
DE Telegram
DataEng DataEng
последний пост 3 days, 10 hours назад
Релиз Apache Airflow 3.4Вышла новая версия Apache Airflow 3.4. Список новых фич можно посмотреть по ссылке — https://github.com/apache/airflow/releases/tag/3.4.0

Релиз Apache Airflow 3.4Вышла новая версия Apache Airflow 3.4. Список новых фич можно посмотреть по ссылке — https://github.com/apache/airflow/releases/tag/3.4.0

3 days, 10 hours назад @ t.me
📬 Новое: еженедельный дайджест вакансийРаз в неделю присылаем на почту несколько новых вакансий для дата/аналитик-инженеров, в которых указаны зарплата, локация и стек, и ссылки на остальные вакансии недели.• Без отслеживания открытий писем• Отписаться мож

📬 Новое: еженедельный дайджест вакансийРаз в неделю присылаем на почту несколько новых вакансий для дата/аналитик-инженеров, в которых указаны зарплата, локация и стек, и ссылки на остальные вакансии недели.• Без отслеживания открытий писем• Отписаться можно в один клик• Не используются сторонние сервисы рассылки👉 Подписаться: https://getdataengineeringjobs.com/digest/Письма приходят на английском

1 week, 3 days назад @ t.me
🔴Собес на Дата Инженера с нанимающим из Сбера в субботу в 15:0017 октября (в эту субботу!) в 15:00 по мск приходи онлайн на открытое собеседование, чтобы посмотреть на настоящее интервью на Middle Дата Инженера.Как это будет:📂 Максим Костин, ведущий инжене
🔴Собес на Дата Инженера с нанимающим из Сбера в субботу в 15:0017 октября (в эту субботу!) в 15:00 по мск приходи онлайн на открытое собеседование, чтобы посмотреть на настоящее интервью на Middle Дата Инженера.Как это будет:📂 Максим Костин, ведущий инжене 🔴Собес на Дата Инженера с нанимающим из Сбера в субботу в 15:0017 октября (в эту субботу!) в 15:00 по мск приходи онлайн на открытое собеседование, чтобы посмотреть на настоящее интервью на Middle Дата Инженера.Как это будет:📂 Максим Костин, ведущий инжене

🔴Собес на Дата Инженера с нанимающим из Сбера в субботу в 15:0017 октября (в эту субботу!) в 15:00 по мск приходи онлайн на открытое собеседование, чтобы посмотреть на настоящее интервью на Middle Дата Инженера.Как это будет:📂 Максим Костин, ведущий инженер данных в Сбере, ex-VK проведет собес на дата инженера;📂 Максим будет задавать реальные вопросы с секций, которые проводил сам и комментировать ответы;📂 В конце можно будет задать любой вопрос Максиму.Это бесплатно. Эфир проходит в рамках менторской программы от ШОРТКАТ для разработчиков, которые хотят сменить работу, повысить свой грейд, ЗП и прокачать скиллы.Переходи в нашего бота, чтобы получить ссылку на эфир → @shortcut_de_bot

3 weeks, 4 days назад @ t.me
Народ, привет! 👋Я запустил агрегатор вакансий по data/analytics/ops engineering: https://getdataengineeringjobs.com/Веб-сайт мониторит открытые вакансии у десятков компаний по всему миру и отбирает те, что попадают под категорию дата инжиниринга, инфрастру

Народ, привет! 👋Я запустил агрегатор вакансий по data/analytics/ops engineering: https://getdataengineeringjobs.com/Веб-сайт мониторит открытые вакансии у десятков компаний по всему миру и отбирает те, что попадают под категорию дата инжиниринга, инфраструктуры и аналитики.Также в автоматическом режиме каждая отобранная вакансия появляется в телеграм-канале @dataeng_jobs, так что подписывайтесь, если вас интересуют предложения по работе со всего мира 🌎База компаний потихоньку пополняется, так что если не нашли какую-то компанию, то можете написать мне, я её добавлю для мониторинга!Все приятного вечера! 🍻

3 weeks, 6 days назад @ t.me
Самый дорогой способ проверить идею — полгода её разрабатывать.Сначала проверьте спрос. Так сделали эти ребята:— Юра выбрал нишу, которую все считают скучной, но там уже платят. Начал с $100 в месяц, через год вышел примерно на $10K.— Денис один собрал AI-

Самый дорогой способ проверить идею — полгода её разрабатывать.Сначала проверьте спрос. Так сделали эти ребята:— Юра выбрал нишу, которую все считают скучной, но там уже платят. Начал с $100 в месяц, через год вышел примерно на $10K.— Денис один собрал AI-игру в Telegram. За первые полтора месяца ~$1 500.— Аня не пишет код, но запустила AI-бота для английского. Первые ~$200 пришли в первый же месяц.Масштабы разные, схема одна:1. Найти, за что люди уже платят.2. Быстро собрать MVP.3. Проверить спрос на живых пользователях.4. Только потом докручивать продукт.Это не рецепт «как точно сделать $10K». Гарантий вообще нет.Но так вы узнаете ответ за недели, а не за год.В @its_capitan разбирают таки…

1 month назад @ t.me
Официальная документация по Python теперь доступна на русском языке: https://blog.python.org/2026/08/the-python-documentation-is-now-available-in-russian/

Официальная документация по Python теперь доступна на русском языке: https://blog.python.org/2026/08/the-python-documentation-is-now-available-in-russian/

2 months, 2 weeks назад @ t.me
PostgreSQL 18 изнутриPostgres Pro выпустили новую версию книги про устройство PostgreSQL: PostgreSQL 18 изнутриВ настоящем издании учтены замечания читателей и исправлены опечатки, а также отражены такие новинки версии PostgreSQL 18, как поддержка асинхрон

PostgreSQL 18 изнутриPostgres Pro выпустили новую версию книги про устройство PostgreSQL: PostgreSQL 18 изнутриВ настоящем издании учтены замечания читателей и исправлены опечатки, а также отражены такие новинки версии PostgreSQL 18, как поддержка асинхронного ввода-вывода, изменения в настройке автоочистки и появление оптимизации пропуска.Скачать по ссылке.

3 months, 3 weeks назад @ t.me
На канале Елизаветы Осетинской вышло интересное интервью с создателем ClickHouse Алексеем Миловидовым: https://www.youtube.com/watch?v=FSGhaMmqWTA

На канале Елизаветы Осетинской вышло интересное интервью с создателем ClickHouse Алексеем Миловидовым: https://www.youtube.com/watch?v=FSGhaMmqWTA

3 months, 3 weeks назад @ t.me
🔥 Три разных человека. Три разных проекта. Один и тот же подход.— Юра взял «скучную» нишу с готовым спросом → сначала печальные $100/мес, через год уже ~$10K/мес— Денис сделал Telegram-игру в одиночку на основе AI → ~ $1500 за 1,5 месяца после запуска— Аня

🔥 Три разных человека. Три разных проекта. Один и тот же подход.— Юра взял «скучную» нишу с готовым спросом → сначала печальные $100/мес, через год уже ~$10K/мес— Денис сделал Telegram-игру в одиночку на основе AI → ~ $1500 за 1,5 месяца после запуска— Аня без кода запустила AI-бота для изучения английского → первые ~$200 уже в 1 месяцРазные результаты. Разный масштаб. Но общие правила:1. не придумывать «гениальную идею», а брать существующий спрос2. делать простой MVP и быстро запускаться3. докручивать монетизацию и продукт по факту использованияРебята сделали всё без команды, без инвестиций, а самое главное — без ожидания «идеального момента». Да, не у всех получается сразу. И не у всех в…

5 months назад @ telegram.me
🔥 Три разных человека. Три разных проекта. Один и тот же подход.— Юра взял «скучную» нишу с готовым спросом → сначала печальные $100/мес, через год уже ~$10K/мес— Денис сделал Telegram-игру в одиночку на основе AI → ~ $1500 за 1,5 месяца после запуска— Аня

🔥 Три разных человека. Три разных проекта. Один и тот же подход.— Юра взял «скучную» нишу с готовым спросом → сначала печальные $100/мес, через год уже ~$10K/мес— Денис сделал Telegram-игру в одиночку на основе AI → ~ $1500 за 1,5 месяца после запуска— Аня без кода запустила AI-бота для изучения английского → первые ~$200 уже в 1 месяцРазные результаты. Разный масштаб. Но общие правила:1. не придумывать «гениальную идею», а брать существующий спрос2. делать простой MVP и быстро запускаться3. докручивать монетизацию и продукт по факту использованияРебята сделали всё без команды, без инвестиций, а самое главное — без ожидания «идеального момента». Да, не у всех получается сразу. И не у всех в…

5 months назад @ t.me
Приглашаем вас на совместный вебинар AXENIX и вендора BR Systems, посвященный XLTable — OLAP‑системе с широким функционалом для работы с данными ClickHouse и Trino и поддержкой протокола XMLA в Excel.Эксперты подробно расскажут об XLTable и его основных пр
Приглашаем вас на совместный вебинар AXENIX и вендора BR Systems, посвященный XLTable — OLAP‑системе с широким функционалом для работы с данными ClickHouse и Trino и поддержкой протокола XMLA в Excel.Эксперты подробно расскажут об XLTable и его основных пр Приглашаем вас на совместный вебинар AXENIX и вендора BR Systems, посвященный XLTable — OLAP‑системе с широким функционалом для работы с данными ClickHouse и Trino и поддержкой протокола XMLA в Excel.Эксперты подробно расскажут об XLTable и его основных пр

Приглашаем вас на совместный вебинар AXENIX и вендора BR Systems, посвященный XLTable — OLAP‑системе с широким функционалом для работы с данными ClickHouse и Trino и поддержкой протокола XMLA в Excel.Эксперты подробно расскажут об XLTable и его основных преимуществах: быстроте внедрения, отсутствии дублирования данных, снижении затрат на TCO, бессрочной лицензии и других.В рамках вебинара вас ждет:🔸Обзор рынка OLAP-систем🔸Демо системы XL Table от BR Systems🔸Разбор реальных кейсов крупных компанийТакже у вас будет возможность задать свои вопросы.Для участия необходимо зарегистрироваться на сайте. На указанную вами почту придет ссылка на вебинар. Подключайтесь к нам 21 мая в 16:00.До встречи!…

5 months, 4 weeks назад @ t.me
PostgreSQL 16: Оптимизация запросов 🖥Вчера случайно заметил, что на Postgres Pro появилась новая книга PostgreSQL 16: Оптимизация запросов.Книга основана на курсе лекций про оптимизацию, который, к слову, также доступен бесплатно.Понравилось, что книга неб

PostgreSQL 16: Оптимизация запросов 🖥Вчера случайно заметил, что на Postgres Pro появилась новая книга PostgreSQL 16: Оптимизация запросов.Книга основана на курсе лекций про оптимизацию, который, к слову, также доступен бесплатно.Понравилось, что книга небольшая и без лишней воды, сразу приступает к делу без длительных прелюдий и философских размышлений.Рекомендую 🍻

6 months, 1 week назад @ telegram.me
PostgreSQL 16: Оптимизация запросов 🖥Вчера случайно заметил, что на Postgres Pro появилась новая книга PostgreSQL 16: Оптимизация запросов.Книга основана на курсе лекций про оптимизацию, который, к слову, также доступен бесплатно.Понравилось, что книга неб

PostgreSQL 16: Оптимизация запросов 🖥Вчера случайно заметил, что на Postgres Pro появилась новая книга PostgreSQL 16: Оптимизация запросов.Книга основана на курсе лекций про оптимизацию, который, к слову, также доступен бесплатно.Понравилось, что книга небольшая и без лишней воды, сразу приступает к делу без длительных прелюдий и философских размышлений.Рекомендую 🍻

6 months, 1 week назад @ t.me
Эффективно управлять сложностью можно через абстракции. Например, через практики внедрения дизайн-паттернов, DDD, выбор более высокоуровневых технологий.РасширяемостьТребования к работе приложений меняются, а значит и оно само должно меняться. Чтобы внесен

Эффективно управлять сложностью можно через абстракции. Например, через практики внедрения дизайн-паттернов, DDD, выбор более высокоуровневых технологий.РасширяемостьТребования к работе приложений меняются, а значит и оно само должно меняться. Чтобы внесение изменений не превратились в страшный сон необходимо постоянно пересматривать организацию кода, закрывать технический долг, внедрять непрерывное тестирование через практики TDD, XP. Чем проще вносить изменения в систему тем выше её расширяемость и тем ниже связность между её частями.

6 months, 2 weeks назад @ t.me
Эффективно управлять сложностью можно через абстракции. Например, через практики внедрения дизайн-паттернов, DDD, выбор более высокоуровневых технологий.РасширяемостьТребования к работе приложений меняются, а значит и оно само должно меняться. Чтобы внесен

Эффективно управлять сложностью можно через абстракции. Например, через практики внедрения дизайн-паттернов, DDD, выбор более высокоуровневых технологий.РасширяемостьТребования к работе приложений меняются, а значит и оно само должно меняться. Чтобы внесение изменений не превратились в страшный сон необходимо постоянно пересматривать организацию кода, закрывать технический долг, внедрять непрерывное тестирование через практики TDD, XP. Чем проще вносить изменения в систему тем выше её расширяемость и тем ниже связность между её частями.

6 months, 2 weeks назад @ telegram.me
Инжиниринг Данных Инжиниринг Данных
последний пост 3 часа назад
Сегодня был на встрече с VP и Director по сетям и партнерам. Они продают товары в штатах в разные сети и анализируют продажи. Там две мадам, которые уже много лет в этой индустрии. Они были прям мега exciting про Claude и показали свой дашборд, который пос
Сегодня был на встрече с VP и Director по сетям и партнерам. Они продают товары в штатах в разные сети и анализируют продажи. Там две мадам, которые уже много лет в этой индустрии. Они были прям мега exciting про Claude и показали свой дашборд, который пос Сегодня был на встрече с VP и Director по сетям и партнерам. Они продают товары в штатах в разные сети и анализируют продажи. Там две мадам, которые уже много лет в этой индустрии. Они были прям мега exciting про Claude и показали свой дашборд, который пос

Сегодня был на встрече с VP и Director по сетям и партнерам. Они продают товары в штатах в разные сети и анализируют продажи. Там две мадам, которые уже много лет в этой индустрии. Они были прям мега exciting про Claude и показали свой дашборд, который построили поверх Snowflake.Там и KPIs, и ключевые insights, business recommendations. Все сами сделали. Результат впечатляет.Но есть нюанс. Я не мог гарантировать, что все метрики правильные, я даже не знаю как это сделано - какие таблицы, какие джоины и фильтры. В целом это лучше, чем ничего, у бизнеса готовый инструмент и советы, как сделать лучше. Бери и делай.Напоминают reels, когда стегаться над ChatGPT - “Привет, у тебя есть час сделать…

3 часа назад @ t.me
Решил добавить серию базовых вещей на Дата Инженеръ. В surfalytics я это называю “just enough”, а на русском будет базовый минимум - SQL, git, Docker, CLI, PythonПервый курс готов: https://dataengineer.ru/practice/sql/В качестве примера будет готовая БД
Решил добавить серию базовых вещей на Дата Инженеръ. В surfalytics я это называю “just enough”,  а на русском будет базовый минимум - SQL, git, Docker, CLI,  PythonПервый курс готов:  https://dataengineer.ru/practice/sql/В качестве примера будет готовая БД Решил добавить серию базовых вещей на Дата Инженеръ. В surfalytics я это называю “just enough”, а на русском будет базовый минимум - SQL, git, Docker, CLI, PythonПервый курс готов: https://dataengineer.ru/practice/sql/В качестве примера будет готовая БД

Решил добавить серию базовых вещей на Дата Инженеръ. В surfalytics я это называю “just enough”, а на русском будет базовый минимум - SQL, git, Docker, CLI, PythonПервый курс готов: https://dataengineer.ru/practice/sql/В качестве примера будет готовая БД duckdb, и задачки

5 часов назад @ t.me
Немножко фоток про то чем занимаюсь, когда заскучал делать дата инжиниринг.Сегодня настроил Nvidia Jetson и подключил к pc серверу с RTX5090.Задача примерно такая:1) симуляцию космоса в Unreal Engine2) спутники летают и коммуницируют, выполняют свою миссию
Немножко фоток про то чем занимаюсь, когда заскучал делать дата инжиниринг.Сегодня настроил Nvidia Jetson и подключил к pc серверу с RTX5090.Задача примерно такая:1) симуляцию космоса в Unreal Engine2) спутники летают и коммуницируют, выполняют свою миссию Немножко фоток про то чем занимаюсь, когда заскучал делать дата инжиниринг.Сегодня настроил Nvidia Jetson и подключил к pc серверу с RTX5090.Задача примерно такая:1) симуляцию космоса в Unreal Engine2) спутники летают и коммуницируют, выполняют свою миссию

Немножко фоток про то чем занимаюсь, когда заскучал делать дата инжиниринг.Сегодня настроил Nvidia Jetson и подключил к pc серверу с RTX5090.Задача примерно такая:1) симуляцию космоса в Unreal Engine2) спутники летают и коммуницируют, выполняют свою миссию3) каждый спутник это один физический jetson4) на PC тренируется модель компьютерного зрения на базе симуляции, inference будет на jetson gpus5) в качестве тестирования hardware in the loop мы превращаем видео в дата сет и скармливаем 2м jetson, модели должны в реальном времени следовать сценарию bench testing, параллельно двигатель для спутника будет тестироваться в вакуумной камере, цель сделать полноценную автономную систему к 20286) эт…

23 часа назад @ t.me
Попытался сравнить РФ стэк и западный, чтобы было понятно, что учить в зависимости от ситуации.https://dataengineer.ru/career/stack-russia-vs-west/Что добавить, изменить?
Попытался сравнить РФ стэк и западный, чтобы было понятно, что учить в зависимости от ситуации.https://dataengineer.ru/career/stack-russia-vs-west/Что добавить, изменить? Попытался сравнить РФ стэк и западный, чтобы было понятно, что учить в зависимости от ситуации.https://dataengineer.ru/career/stack-russia-vs-west/Что добавить, изменить?

Попытался сравнить РФ стэк и западный, чтобы было понятно, что учить в зависимости от ситуации.https://dataengineer.ru/career/stack-russia-vs-west/Что добавить, изменить?

1 day, 21 hours назад @ t.me
Вот такой план на развитие карьерыhttps://dataengineer.ru/Но еще нужно будет добавить побольше информации.Можете еще подкинуть идей про секции.
Вот такой план на развитие карьерыhttps://dataengineer.ru/Но еще нужно будет добавить побольше информации.Можете еще подкинуть идей про секции. Вот такой план на развитие карьерыhttps://dataengineer.ru/Но еще нужно будет добавить побольше информации.Можете еще подкинуть идей про секции.

Вот такой план на развитие карьерыhttps://dataengineer.ru/Но еще нужно будет добавить побольше информации.Можете еще подкинуть идей про секции.

2 days, 7 hours назад @ t.me
Классика про бизнес с друзьями https://t.me/Theedinorogblog/8208Грустно, что так получилось, возможно на data day можно будет спросить, почему так получилось.

Классика про бизнес с друзьями https://t.me/Theedinorogblog/8208Грустно, что так получилось, возможно на data day можно будет спросить, почему так получилось.

2 days, 9 hours назад @ t.me
Higgsfield Data Day - трансляция открытаДоклады с 13:00 МСК: данные, AI-агенты, антифрод и A/B-тесты. Смотреть на YouTubeПрограмма (по МСК):13:00 - открытие, Ерзат Дулат, CTO и co-founder Higgsfield13:15 - Ануар Аймолдин (DSML) - «AI на стыке коммьюнити, р
Higgsfield Data Day - трансляция открытаДоклады с 13:00 МСК: данные, AI-агенты, антифрод и A/B-тесты. Смотреть на YouTubeПрограмма (по МСК):13:00 - открытие, Ерзат Дулат, CTO и co-founder Higgsfield13:15 - Ануар Аймолдин (DSML) - «AI на стыке коммьюнити, р Higgsfield Data Day - трансляция открытаДоклады с 13:00 МСК: данные, AI-агенты, антифрод и A/B-тесты. Смотреть на YouTubeПрограмма (по МСК):13:00 - открытие, Ерзат Дулат, CTO и co-founder Higgsfield13:15 - Ануар Аймолдин (DSML) - «AI на стыке коммьюнити, р

Higgsfield Data Day - трансляция открытаДоклады с 13:00 МСК: данные, AI-агенты, антифрод и A/B-тесты. Смотреть на YouTubeПрограмма (по МСК):13:00 - открытие, Ерзат Дулат, CTO и co-founder Higgsfield13:15 - Ануар Аймолдин (DSML) - «AI на стыке коммьюнити, рисерча и индустрии»13:45 - Валерий Бабушкин - «Детерминизм как точка опоры в мире Agentic AI»14:15 - Игорь Котенков (Сиолошная) - «Похожие оценки - разные истории»15:00 - Роман Ященко (Higgsfield) - «Я дал агенту кнопку бана на 50 000 аккаунтов»15:30 - Анатолий Карпов (KarpovCourses) - «Симулируй, прежде чем тестировать: A/B-тесты от Монте-Карло до синтетических пользователей»16:00 - Дидар Нуркаир (Higgsfield) - «Higgsfield на допросе у VC…

2 days, 13 hours назад @ t.me
Заключительный пост про поиск работы - Валютная Удаленка.Это миф или реальность? Можно ли работать из РФ? Ответ - можно все. Но при этом все меняется часто - от условий и требований иностранных банков, до доступа в интернет. Я знаю много людей, кто так р
Заключительный пост про поиск  работы -  Валютная Удаленка.Это миф или реальность? Можно ли работать из РФ? Ответ - можно все. Но при этом все меняется часто - от условий и требований иностранных банков, до доступа в интернет. Я знаю много людей, кто так р Заключительный пост про поиск работы - Валютная Удаленка.Это миф или реальность? Можно ли работать из РФ? Ответ - можно все. Но при этом все меняется часто - от условий и требований иностранных банков, до доступа в интернет. Я знаю много людей, кто так р

Заключительный пост про поиск работы - Валютная Удаленка.Это миф или реальность? Можно ли работать из РФ? Ответ - можно все. Но при этом все меняется часто - от условий и требований иностранных банков, до доступа в интернет. Я знаю много людей, кто так работает по очень разным схемам, но все работает. Поиск очевидно сложней, требования выше. Главное требование - сначала станьте экспертом в том, что вы делаете в РФ и потом уже можно искать дополнительный заработок. Многие хотят сразу и работу новую, да еще и за доллары и евро. Так не бывает. То же самое про 2ю, 3ю работу. Пока вы не станете экспертом в том, что вы делает, новая работа вам не поможет, а только все усугубит. Ну и агенты тоже н…

3 days, 7 hours назад @ t.me
Добавил треки вакансий и описание требований https://dataengineer.ru/career/career-tracks/ - на базе самого популярного поста про Roadmaps для дата профессий в Surfalytics. PS вижу пессимистичные комментарии, что все пропало, ИИ нас заменит. Просто поменял

Добавил треки вакансий и описание требований https://dataengineer.ru/career/career-tracks/ - на базе самого популярного поста про Roadmaps для дата профессий в Surfalytics. PS вижу пессимистичные комментарии, что все пропало, ИИ нас заменит. Просто поменялись ожидания.На это неделе я был на offsite в Америке у большой компании (S&P500). Data org сократила 45% людей. Причина не в ИИ, а в том, что люди просто по инерции продолжали делать свою работу - keep lights on. Они могли дискутировать часами о бесполезных вещах, играть в “ping pong” в slack, но как обычно 0 результата для бизнеса. Главный message от руководителей - они хотят людей, которые проактивны, могут сами понять, что делать и как…

4 days, 7 hours назад @ t.me
Легендарный курс про поиск работы на русском бесплатно и без регистрации https://dataengineer.ru/career/job-search/

Легендарный курс про поиск работы на русском бесплатно и без регистрации https://dataengineer.ru/career/job-search/

4 days, 23 hours назад @ t.me
Добавил про Codex https://dataengineer.ru/ai/codex-101/ и про Pi/OpenCode https://dataengineer.ru/ai/open-agents-101/Обновил страницу про инструменты https://dataengineer.ru/ai/ai-tools/PS у вас тоже есть возможность добавлять материалы на любую полезную т

Добавил про Codex https://dataengineer.ru/ai/codex-101/ и про Pi/OpenCode https://dataengineer.ru/ai/open-agents-101/Обновил страницу про инструменты https://dataengineer.ru/ai/ai-tools/PS у вас тоже есть возможность добавлять материалы на любую полезную тему.

5 days, 8 hours назад @ t.me
Освежил курс по Claude 101 и тему сайта. https://dataengineer.ru/ai/claude-code-101/

Освежил курс по Claude 101 и тему сайта. https://dataengineer.ru/ai/claude-code-101/

6 days, 23 hours назад @ t.me
Скоро 40 лет🤦‍♂️. По Российским ИТ меркам я дед и меня не возьмут на работу. Я думал надо будет написать пост с результатами, а решил лучше вебинар - дата инженер в 40 лет миф или реальность? Можно столько всего интересного рассказать, собрать метрики и по

Скоро 40 лет🤦‍♂️. По Российским ИТ меркам я дед и меня не возьмут на работу. Я думал надо будет написать пост с результатами, а решил лучше вебинар - дата инженер в 40 лет миф или реальность? Можно столько всего интересного рассказать, собрать метрики и подумать над вопросом - «стакана на половину пуст, или на половину полон». Главный вывод - это не результат, а мои действия на любой запрос, идею, мысль. Даже если нет успеха, знать, что я выложился на 💯 не жалея себя, значит это и есть хороший результат. В комментах напишите вопросы, я постараюсь осветить их в вебинаре. PS 40 не отмечают, но я потом покажу как я отметил день рождение в прошлом, что месяц назад меня уволил Microsoft до 6 лет…

1 week назад @ t.me
Новая книга: Data Engineering for Multimodal AIМультимодальный AI — это не только про сложные модели и промпты, а в первую очередь про тяжёлую инфраструктуру данных. Новая книга раскладывает архитектуру мультимодальных систем по полочкам: от сбора разнород
Новая книга: Data Engineering for Multimodal AIМультимодальный AI — это не только про сложные модели и промпты, а в первую очередь про тяжёлую инфраструктуру данных. Новая книга раскладывает архитектуру мультимодальных систем по полочкам: от сбора разнород Новая книга: Data Engineering for Multimodal AIМультимодальный AI — это не только про сложные модели и промпты, а в первую очередь про тяжёлую инфраструктуру данных. Новая книга раскладывает архитектуру мультимодальных систем по полочкам: от сбора разнород

Новая книга: Data Engineering for Multimodal AIМультимодальный AI — это не только про сложные модели и промпты, а в первую очередь про тяжёлую инфраструктуру данных. Новая книга раскладывает архитектуру мультимодальных систем по полочкам: от сбора разнородных данных до продакшн-деплоя и контроля расходов.О чём книга:Хранение и пайплайны: семантические слои, data contracts и валидация текста, аудио, видео и картинок.Фичи и поиск: мультимодальные feature stores, слияние признаков (fusion), векторный поиск + графы знаний (hybrid retrieval).MLOps и стриминг: выравнивание событий, мониторинг, версионирование и автопереобучение.Продакшн и безопасность: распределённый инференс, оптимизация костов …

1 week, 1 day назад @ t.me
Настроил себе Orca IDE, добавил в телефон их приложение. Пока выглядит все очень хорошо, я даже готов платить им. Работал утром дома, продолжаю в дороге с телефона. Каждый агент еще умеет читать slack, email и через MCP имеет доступ везде где нужно. Реальн
Настроил себе Orca IDE, добавил в телефон их приложение. Пока выглядит все очень хорошо, я даже готов платить им. Работал утром дома, продолжаю в дороге с телефона. Каждый агент еще умеет читать slack, email и через MCP имеет доступ везде где нужно. Реальн Настроил себе Orca IDE, добавил в телефон их приложение. Пока выглядит все очень хорошо, я даже готов платить им. Работал утром дома, продолжаю в дороге с телефона. Каждый агент еще умеет читать slack, email и через MCP имеет доступ везде где нужно. Реальн

Настроил себе Orca IDE, добавил в телефон их приложение. Пока выглядит все очень хорошо, я даже готов платить им. Работал утром дома, продолжаю в дороге с телефона. Каждый агент еще умеет читать slack, email и через MCP имеет доступ везде где нужно. Реально эффективно получается.

1 week, 2 days назад @ t.me
Left Join Left Join
последний пост 13 часов назад
Что нового в Apache Airflow 3.4.0? В конце прошлой недели Apache выкатили новую версию Airflow, где представили несколько интересных изменений:1️⃣Появилась нативная поддержка циклов — Task Loops, которые могут повторяться либо до выполнения определенного у

Что нового в Apache Airflow 3.4.0? В конце прошлой недели Apache выкатили новую версию Airflow, где представили несколько интересных изменений:1️⃣Появилась нативная поддержка циклов — Task Loops, которые могут повторяться либо до выполнения определенного условия, либо некое заранее заданное максимальное число итераций. Каждая итерация строится на результатах предыдущей.Прежде чем двигаться дальше, стоит прояснить один момент: «Как в DAG могут быть циклы, если DAG — это Directed Acyclic Graph (направленный ациклический граф)?» Ответ: очень осторожно. По сути, никаких циклических зависимостей не возникает, задачи внутри DAG по-прежнему образуют граф без циклов. Повторение задач реализуется ис…

13 часов назад @ t.me
Наступила пятница, и это значит, что пора подводить итоги нашего розыгрыша билетов на Матемаркетинг'26!Рандомайзер постановил, что: 🔵Офлайн-билет достается @gottameow🔵Онлайн-доступ — @Lidialit и @GofromchuСкоро с вами свяжутся организаторы конференции и ра

Наступила пятница, и это значит, что пора подводить итоги нашего розыгрыша билетов на Матемаркетинг'26!Рандомайзер постановил, что: 🔵Офлайн-билет достается @gottameow🔵Онлайн-доступ — @Lidialit и @GofromchuСкоро с вами свяжутся организаторы конференции и расскажут про дальнейшие шаги. Благодарим всех, кто принял участие, и поздравляем победителей! До встречи на Матемаркетинге🔥

3 days, 13 hours назад @ t.me
Напоминаем про две важных вещи: 1️⃣ 26-27 ноября пройдет Матемаркетинг — конференция по маркетинговой и продуктовой аналитике. 2000+ участников, 100+ докладов про данные, метрики, инжиниринг и искусственный интеллект.2️⃣ Вы можете попасть туда (или посмотр

Напоминаем про две важных вещи: 1️⃣ 26-27 ноября пройдет Матемаркетинг — конференция по маркетинговой и продуктовой аналитике. 2000+ участников, 100+ докладов про данные, метрики, инжиниринг и искусственный интеллект.2️⃣ Вы можете попасть туда (или посмотреть прямой эфир онлайн) бесплатно, если примете участие в нашем розыгрыше. Условия — в посте. Итоги подводим уже в эту пятницу.

5 days, 13 hours назад @ t.me
ИИ без страха: пять дней, чтобы сделать первые шагиGlowbyte вместе с DataYoga приглашают на бесплатный онлайн-марафон об адаптации к ИИ в российских компаниях.ИИ берёт на себя рутину, и роли меняются. Аналитикам важнее ставить задачи и проверять результаты
ИИ без страха: пять дней, чтобы сделать первые шагиGlowbyte вместе с DataYoga приглашают на бесплатный онлайн-марафон об адаптации к ИИ в российских компаниях.ИИ берёт на себя рутину, и роли меняются. Аналитикам важнее ставить задачи и проверять результаты ИИ без страха: пять дней, чтобы сделать первые шагиGlowbyte вместе с DataYoga приглашают на бесплатный онлайн-марафон об адаптации к ИИ в российских компаниях.ИИ берёт на себя рутину, и роли меняются. Аналитикам важнее ставить задачи и проверять результаты

ИИ без страха: пять дней, чтобы сделать первые шагиGlowbyte вместе с DataYoga приглашают на бесплатный онлайн-марафон об адаптации к ИИ в российских компаниях.ИИ берёт на себя рутину, и роли меняются. Аналитикам важнее ставить задачи и проверять результаты, руководителям важнее ориентироваться в сценариях, рисках и сопротивлении сотрудников. На марафоне разберут, как в этом не потеряться.9–13 ноября, онлайн. Каждый день: одна тема, эфир с экспертами из российских компаний-лидеров, которые уже работают с ИИ, и материалы на страницах марафона: практика, шаблоны и чек-листы.Вы узнаете:🔵какие задачи стоит отдавать ИИ, а какие требуют других решений;🔵как отличать убедительный ответ ИИ от провере…

6 days, 14 hours назад @ t.me
OcupySaaS: протест инженеров против ИТ-индустрииДискуссия про отнимающий работу ИИ получила неожиданное (или, наоборот, вполне ожидаемое?) развитие: уволенные инженеры скооперировались и начали делать опен-сорсные аналоги популярных платформ. Они собирают

OcupySaaS: протест инженеров против ИТ-индустрииДискуссия про отнимающий работу ИИ получила неожиданное (или, наоборот, вполне ожидаемое?) развитие: уволенные инженеры скооперировались и начали делать опен-сорсные аналоги популярных платформ. Они собирают данные из публичных документов, на их основе ИИ-агенты пишут код, который затем оценивают и тестируют люди. Команда проекта подчеркивает, что они не декомпилируют чужой софт, а все делают с нуля по принципу clean room. Даже если к разработке присоединяются бывшие сотрудники компаний, для чьих продуктов OcupySaaS создает аналог, они должны опираться только на данные из открытых источников, а не сливать корпоративные тайны.Продуктов у команд…

1 week назад @ t.me
Разыгрываем 3 билета на Матемаркетинг’26!🔵 Как ИИ меняет работу аналитиков, маркетологов и продактов?🔵 Как посчитать, сколько людей на самом деле используют ИИ в работе в вашей компании?🔵 Как контролировать и проверять работу ИИ и можно ли ему вообще дове
Разыгрываем 3 билета на Матемаркетинг’26!🔵 Как ИИ меняет работу аналитиков, маркетологов и продактов?🔵 Как посчитать, сколько людей на самом деле используют ИИ в работе в вашей компании?🔵  Как контролировать и проверять работу ИИ и можно ли ему вообще дове Разыгрываем 3 билета на Матемаркетинг’26!🔵 Как ИИ меняет работу аналитиков, маркетологов и продактов?🔵 Как посчитать, сколько людей на самом деле используют ИИ в работе в вашей компании?🔵 Как контролировать и проверять работу ИИ и можно ли ему вообще дове

Разыгрываем 3 билета на Матемаркетинг’26!🔵 Как ИИ меняет работу аналитиков, маркетологов и продактов?🔵 Как посчитать, сколько людей на самом деле используют ИИ в работе в вашей компании?🔵 Как контролировать и проверять работу ИИ и можно ли ему вообще доверять?Эти и другие вопросы обсудят на Матемаркетинге’26. Это одна из крупнейших технических конференций для аналитиков, продактов и маркетологов в РФ. В этом году посетителей ждут 100+ докладов, мастер-классов и разборов кейсов от спикеров из VK, Avito Tech, Сбера, Magnit Tech, ИТ-холдинга Т1, UIS, Лемана Тех, UX Rocket и других компаний.Конференция пройдет 26 и 27 ноября в Москве, онлайн-день — 17 ноября. Подробности смотрите на сайте.🔜 Бил…

1 week, 3 days назад @ t.me
Датавиз и классовое неравенство Разница между состоянием какого-нибудь Джеффа Безоса и обычного человека со средней зарплатой настолько огромна, что словами ее передать не получается. Зато можно попробовать это сделать с помощью датаиза. Депрессивные визуа

Датавиз и классовое неравенство Разница между состоянием какого-нибудь Джеффа Безоса и обычного человека со средней зарплатой настолько огромна, что словами ее передать не получается. Зато можно попробовать это сделать с помощью датаиза. Депрессивные визуализации все растущего разрыва между богатыми и бедными — это неустаревающая классика. Инфографик на эту тему уже немало и рисовать не перестанут, наверное, никогда, но смотреть на них всегда интересно. 🔜 Сайт dreamagainusa — очередной пример, который показывает, как недостижимо далек даже относительно успешный и состоятельный американец от настоящего богатства. Чтобы увидеть вершину графика, где расположился 1% самых богатых людей страны, …

1 week, 4 days назад @ t.me
Как SQLite учили работать в распределенных системахSQLite — пример для нас всех. Это маленькая и легкая СУБД, которая создавалась изначально для небольших проектов и мобильных приложений, но потенциал у нее огромный и использовать ее можно где угодно, было

Как SQLite учили работать в распределенных системахSQLite — пример для нас всех. Это маленькая и легкая СУБД, которая создавалась изначально для небольших проектов и мобильных приложений, но потенциал у нее огромный и использовать ее можно где угодно, было бы желание. Например, в распределенных системах. Автор rqlite вспомнил, как создал свой проект и что было после него. 🔵В 2014 году ему понадобилось создать небольшое реляционное хранилище для кластерной системы. Он решил взять SQLite и прикрутить к ней протокол консенсуса Raft. В это системе В кластере был лидер, через которого новые записи принимались и реплицировались на остальные узлы. Запись должно было принять большинство, если какой…

2 weeks назад @ t.me
20 лет отношений через призму данныхЕсли бы вам нужно было на графиках отобразить свою жизнь, как бы выглядел ваш дашборд? В этом посте от 2014 года автор показывает жизнь как таблицу, где каждая клеточка — это год, месяц или неделя. Пост старй, вы наверня

20 лет отношений через призму данныхЕсли бы вам нужно было на графиках отобразить свою жизнь, как бы выглядел ваш дашборд? В этом посте от 2014 года автор показывает жизнь как таблицу, где каждая клеточка — это год, месяц или неделя. Пост старй, вы наверняка видели раньше эти таблички хотя бы раз. Один разработчик и инженер тоже их видел, и они ему не понравились. Он решил сделать свою версию, отражающую не число прожитых дней, а то, чем они были наполнены: эмоциями и общением с людьми.🔵Он собрал историю чатов и активности из разных соцсетей и мессенджеров за 20 лет, очистил от совсем уж бессмысленных сообщений и классифицировал: с кем разговаривал, о чем, какая была эмоциональная окраска у…

2 weeks, 3 days назад @ t.me
Clickhouse на больших объемах данных: опыт основателя TinybirdTinybird — аналитическая платформа для разработчиков. Один из ее создателей поделился опытом, как он развернул и 5 лет поддерживал кластер Clickhouse, где хранились и обрабатывались петабайты да

Clickhouse на больших объемах данных: опыт основателя TinybirdTinybird — аналитическая платформа для разработчиков. Один из ее создателей поделился опытом, как он развернул и 5 лет поддерживал кластер Clickhouse, где хранились и обрабатывались петабайты данных, и не сошел с ума. В двух постах (первый, второй) он рассказал про архитектуру, хранение и загрузку данных, обновление и тестирование. Несколько любопытных мыслей:🔵Традиционный подход к работе с большими данными предполагает деление кластера на шарды, но автор считает, что с этим лучше не спешить и не усложнять архитектуру. Tinybirds долго обходились без шардирования: увеличивали мощность отдельных серверов и добавляли реплики, когда …

2 weeks, 5 days назад @ t.me
PostgreSQL 19 откладывается на ноябрь Новая версия должна была выйти в конце сентября/начале октября, но дату релиза сдвинули на 19 ноября. Также решили откатить почти 10 ранее анонсированных функций. Их перенесут, скорее всего, в PostgreSQL 20.Почему так

PostgreSQL 19 откладывается на ноябрь Новая версия должна была выйти в конце сентября/начале октября, но дату релиза сдвинули на 19 ноября. Также решили откатить почти 10 ранее анонсированных функций. Их перенесут, скорее всего, в PostgreSQL 20.Почему так получилось, рассказал у себя в блоге один из главных контрибьюторов проекта Питер Айзентраут. Частично, конечно, в сложившейся ситуации можно обвинить человеческий фактор и банальные ошибки в коде, но повлияли и другие причины: 🔵ИИ нашел множество багов — намного больше, чем тестировщики выловили бы своими силами. Среди них были и серьезные архитектурные дефекты, и пограничные случаи, которые постепенно всплывали бы на протяжении лет после…

3 weeks назад @ t.me
До Claude и ChatGPTПару лет назад ИИ не мог посчитать, сколько букв a в strawberry, а теперь решает математические задачи тысячелетия — а что будет дальше, и представить сложно. Хотя некоторые представили и предсказали, что он нас всех уничтожит к 2030 год
До Claude и ChatGPTПару лет назад ИИ не мог посчитать, сколько букв a в strawberry, а теперь решает математические задачи тысячелетия — а что будет дальше, и представить сложно. Хотя некоторые представили и предсказали, что он нас всех уничтожит к 2030 год До Claude и ChatGPTПару лет назад ИИ не мог посчитать, сколько букв a в strawberry, а теперь решает математические задачи тысячелетия — а что будет дальше, и представить сложно. Хотя некоторые представили и предсказали, что он нас всех уничтожит к 2030 год

До Claude и ChatGPTПару лет назад ИИ не мог посчитать, сколько букв a в strawberry, а теперь решает математические задачи тысячелетия — а что будет дальше, и представить сложно. Хотя некоторые представили и предсказали, что он нас всех уничтожит к 2030 году. И чем быстрее развиваются современные технологии, Тем интереснее сравнить их с ранними попытками создать искусственный интеллект. Internet Archive сделали целую подборку старых программ с прото-ИИ: чат-ботов, демо-моделей, игр. Есть даже прародительница Sims и «Хоббит», где персонажи действуют самостоятельно и настолько непредсказуемо, что могут даже запороть игроку прохождение. Конечно, этот ИИ ужасно далек от того, что есть сейчас, и …

3 weeks, 3 days назад @ t.me
Claude помог обнаружить новую планетуНаверное.Пользователь reddit проанализировал данные, собранные телескопом TESS, и обнаружил, что звезда на расстоянии 116 лет от нас каждые 3,18 дня становится на 0,05% тусклее. Вместе с Opus 5.5 и Fable 5.1 он прошерст

Claude помог обнаружить новую планетуНаверное.Пользователь reddit проанализировал данные, собранные телескопом TESS, и обнаружил, что звезда на расстоянии 116 лет от нас каждые 3,18 дня становится на 0,05% тусклее. Вместе с Opus 5.5 и Fable 5.1 он прошерстил информацию за все годы наблюдений, начиная с 2018, и увидел, что этот цикл повторяется на протяжении всех этих лет. Возможной причиной этих периодических затемнений может быть планета примерно в полтора раза больше Земли. А может и не быть — эта гипотеза пока не подтверждена, но, возможно, скоро мы узнаем об этом небесном теле чуть-чуть больше. В ноябре NASA опять вернется к наблюдению за этим участком неба, и автор поста написал им о с…

3 weeks, 5 days назад @ t.me
4 уровня ИИ-осведомленностиЕще в апреле Андрей Карпаты (автор термина «вайбкодинг», если забыли) писал о том, как растет разница в понимании возможностей ИИ. Те, кто пользуется бесплатными версиями для простых задач, и те, кто пользуется платными моделями

4 уровня ИИ-осведомленностиЕще в апреле Андрей Карпаты (автор термина «вайбкодинг», если забыли) писал о том, как растет разница в понимании возможностей ИИ. Те, кто пользуется бесплатными версиями для простых задач, и те, кто пользуется платными моделями для работы и научной деятельности, говорят про ИИ на разных языках. Сейчас разрыв только вырос, и это больше не две разных группы, а резко сужающаяся воронка. По его прикидкам, она выглядит так: 🔵~75% или 6 млрд людей с ИИ почти не сталкивались.🔵~20% или 1-2 млрд — «казуалы», которые используют бесплатные продукты, с ИИ в общем знакомы, но глубоко в тему не погружены. Эти люди просят ChatPGT написать письмо, и больше им ничего особо не над…

4 weeks назад @ t.me
Anthropic представила Claude Dashboards и Claude Motion И вот опять ИИ отбирает работу у аналитиков: Claude теперь умеет создавать и даже анимировать дашборды на основе пользовательских данных.. Claude DashboardsClaude можно подключить к БД и задать любой

Anthropic представила Claude Dashboards и Claude Motion И вот опять ИИ отбирает работу у аналитиков: Claude теперь умеет создавать и даже анимировать дашборды на основе пользовательских данных.. Claude DashboardsClaude можно подключить к БД и задать любой вопрос, а он достанет ответы из данных, нарисует дашборд и даже будет сам поддерживать актуальность. На каждую цифру на графиках можно кликнуть, чтобы посмотреть, каким запросом Claude ее получил, или задать уточняющие вопросы. Дашборды Claude можно импортировать в Amplitude, Grafana, Hex, Mixpanel, Omni, Perplexity, PostHog и Sigma. Looker, monday.com и Tableau добавят позже. Claude MotionДашборд можно анимировать: сделать видео, где Clau…

1 month назад @ t.me
SQLite на практике SQLite на практике
последний пост None
Datalytics Datalytics
последний пост 11 часов назад
Часть работы аналитика уже можно передать ИИ-агентам, а освободившееся время потратить на гипотезы и интерпретацию. Как это устроить, разберут на AI Analytics Week — бесплатном онлайн-интенсиве Школы анализа данных Яндекса, который пройдёт с 23 по 27 ноябр
Часть работы аналитика уже можно передать ИИ-агентам, а освободившееся время потратить на гипотезы и интерпретацию. Как это устроить, разберут на AI Analytics Week — бесплатном онлайн-интенсиве Школы анализа данных Яндекса, который пройдёт с 23 по 27 ноябр Часть работы аналитика уже можно передать ИИ-агентам, а освободившееся время потратить на гипотезы и интерпретацию. Как это устроить, разберут на AI Analytics Week — бесплатном онлайн-интенсиве Школы анализа данных Яндекса, который пройдёт с 23 по 27 ноябр

Часть работы аналитика уже можно передать ИИ-агентам, а освободившееся время потратить на гипотезы и интерпретацию. Как это устроить, разберут на AI Analytics Week — бесплатном онлайн-интенсиве Школы анализа данных Яндекса, который пройдёт с 23 по 27 ноября.Главные темы:— Автоматизация очистки данных с LLM— Расчёт выборки, стратификация и синтетический контроль с помощью LLM— Агентная система, которая связывает отдельные шаги анализа в единый пайплайнВесь путь от бизнес-гипотезы до агента-аналитика покажут на кейсах Яндекса. Для участия нужны SQL, Python, базовая статистика и основы ML. Подойдёт продуктовым, бизнес- и data-аналитикам, ML-инженерам и специалистам по Data ScienceРегистрируйте…

11 часов назад @ t.me
🧩 Product Analyst @ Higgsfield AIHiggsfield AI — самая быстрорастущая AI-компания в истории.За 18 месяцев с запуска наша команда достигла $1B ARR, а 133 сотрудника уже стали долларовыми миллионерами. Ты можешь стать следующим.Что предлагаем:🌍 35M+ пользова

🧩 Product Analyst @ Higgsfield AIHiggsfield AI — самая быстрорастущая AI-компания в истории.За 18 месяцев с запуска наша команда достигла $1B ARR, а 133 сотрудника уже стали долларовыми миллионерами. Ты можешь стать следующим.Что предлагаем:🌍 35M+ пользователей и user flow, которых полгода назад не было. Первым выясняй, что теперь даёт активацию, удержание и оплату.🧪 Плейбуки ещё пишутся. Ты создаёшь их сам. Выбирай метрики и проверяй гипотезы на масштабе $1B ARR.💵 Конкурентная зарплата в USD + опционы (Goldman Sachs уже покупает акции ранних сотрудников)Кого ищем:• 2+ года в продуктовой аналитике, уверенный SQL• Знание статистики, A/B-тестов, воронок и когортного анализа• Опыт анализа акти…

2 weeks, 5 days назад @ t.me
26–27 ноября в Москве в девятый раз пройдёт техническая конференция для аналитиков, performance-маркетологов и продакт-менеджеров. Онлайн-день — 17 ноября. Более 2000 участников, 100+ докладов и мастер-классов. Партнёры — VK, Avito Tech, Сбер, Magnit Tech,
26–27 ноября в Москве в девятый раз пройдёт техническая конференция для аналитиков, performance-маркетологов и продакт-менеджеров. Онлайн-день — 17 ноября. Более 2000 участников, 100+ докладов и мастер-классов. Партнёры — VK, Avito Tech, Сбер, Magnit Tech, 26–27 ноября в Москве в девятый раз пройдёт техническая конференция для аналитиков, performance-маркетологов и продакт-менеджеров. Онлайн-день — 17 ноября. Более 2000 участников, 100+ докладов и мастер-классов. Партнёры — VK, Avito Tech, Сбер, Magnit Tech,

26–27 ноября в Москве в девятый раз пройдёт техническая конференция для аналитиков, performance-маркетологов и продакт-менеджеров. Онлайн-день — 17 ноября. Более 2000 участников, 100+ докладов и мастер-классов. Партнёры — VK, Avito Tech, Сбер, Magnit Tech, ИТ-холдинг Т1, ТехВилл, UIS, Лемана Тех, UX Rocket и другие компании.Среди спикеров:• Валерий Бабушкин (ВР): как прогресс мультимодальных моделей влияет на профессию DS/DA/ML• Роман Бунин (Nebius): как измерить внедрение ИИ в большой компании• Денис Пехтерев (Т-Банк): ИИ-операционная система руководителя из 17 ролей и 13 процедур• Радослав Нейчев (МФТИ): рабочие сценарии для агентов на открытом стеке, без платных подписок• Сергей Бажин (И…

2 weeks, 6 days назад @ t.me
В субботу, 17 октября, Москва станет точкой притяжения для всех специалистов в области RecSys 🔥Конференция AI Driver & RecSys — главное событие года для тех, кто создаёт, исследует и развивает рекомендательные системы. 🔝 Весь день ведущие эксперты инду
В субботу, 17 октября, Москва станет точкой притяжения для всех специалистов в области RecSys 🔥Конференция AI Driver &amp; RecSys — главное событие года для тех, кто создаёт, исследует и развивает рекомендательные системы. 🔝 Весь день ведущие эксперты инду В субботу, 17 октября, Москва станет точкой притяжения для всех специалистов в области RecSys 🔥Конференция AI Driver &amp; RecSys — главное событие года для тех, кто создаёт, исследует и развивает рекомендательные системы. 🔝 Весь день ведущие эксперты инду

В субботу, 17 октября, Москва станет точкой притяжения для всех специалистов в области RecSys 🔥Конференция AI Driver & RecSys — главное событие года для тех, кто создаёт, исследует и развивает рекомендательные системы. 🔝 Весь день ведущие эксперты индустрии из крупнейших IT-компаний проведут на площадке Сбера, чтобы обсудить:— главные тренды и вызовы RecSys— реальные кейсы и новейшие исследования— передовые IT-решения для рекомендательных системВы сможете сами пообщаться с теми, кто создает рекомендации для миллионов пользователей.📍Офис Сбер, Москва, Кутузовский проспект, 32.Участие бесплатное!Количество мест для очного участия ограничено – успейте оставить заявку по ссылке ⚡️

3 weeks, 5 days назад @ t.me
RAG, AI-агенты и модели в продакшене. В @llm_jobs публикуются вакансии для тех, кто создаёт AI-продукты: от инженеров и дата-сайентистов до продактов. Есть удалёнка, гибрид и офис.
RAG, AI-агенты и модели в продакшене. В @llm_jobs публикуются вакансии для тех, кто создаёт AI-продукты: от инженеров и дата-сайентистов до продактов. Есть удалёнка, гибрид и офис. RAG, AI-агенты и модели в продакшене. В @llm_jobs публикуются вакансии для тех, кто создаёт AI-продукты: от инженеров и дата-сайентистов до продактов. Есть удалёнка, гибрид и офис.

RAG, AI-агенты и модели в продакшене. В @llm_jobs публикуются вакансии для тех, кто создаёт AI-продукты: от инженеров и дата-сайентистов до продактов. Есть удалёнка, гибрид и офис.

3 weeks, 5 days назад @ t.me
Что, если заменить аналитиков нейросетью?Да ничего хорошего: результаты анализа получаются слишком общими, и половину работы потом всё равно приходится переделывать руками.Хард-скилы дешевеют — SQL-запрос или кусок кода теперь может сгенерировать почти кто
Что, если заменить аналитиков нейросетью?Да ничего хорошего: результаты анализа получаются слишком общими, и половину работы потом всё равно приходится переделывать руками.Хард-скилы дешевеют — SQL-запрос или кусок кода теперь может сгенерировать почти кто Что, если заменить аналитиков нейросетью?Да ничего хорошего: результаты анализа получаются слишком общими, и половину работы потом всё равно приходится переделывать руками.Хард-скилы дешевеют — SQL-запрос или кусок кода теперь может сгенерировать почти кто

Что, если заменить аналитиков нейросетью?Да ничего хорошего: результаты анализа получаются слишком общими, и половину работы потом всё равно приходится переделывать руками.Хард-скилы дешевеют — SQL-запрос или кусок кода теперь может сгенерировать почти кто угодно. А вот доменная экспертиза и умение работать с агентом становятся ценнее: правильно задать вопрос, собрать контекст, проверить, что результат не искажён.Три аналитика Авито на конкретных примерах рассказывают, как работает тандем аналитик + AI. Делятся кейсами:➡️ как перенесли 200 витрин за полгода;➡️ автоматизировали проверку работы сотрудников;➡️ научили LLM анализировать метрики.Подробнее в ролике:📺 YouTube🔵 ВКБольше честных ист…

1 month назад @ t.me
5 октября начнется 19-й поток программы Data Engineer от NewprolabПрограмма для junior- и middle-дата-инженеров, аналитиков, backend-разработчиков, техлидов и тех, кто работает с data-командами и хочет лучше понимать современный стек DE📌 Что внутри:– 10 не
5 октября начнется 19-й поток программы Data Engineer от NewprolabПрограмма для junior- и middle-дата-инженеров, аналитиков, backend-разработчиков, техлидов и тех, кто работает с data-командами и хочет лучше понимать современный стек DE📌 Что внутри:– 10 не 5 октября начнется 19-й поток программы Data Engineer от NewprolabПрограмма для junior- и middle-дата-инженеров, аналитиков, backend-разработчиков, техлидов и тех, кто работает с data-командами и хочет лучше понимать современный стек DE📌 Что внутри:– 10 не

5 октября начнется 19-й поток программы Data Engineer от NewprolabПрограмма для junior- и middle-дата-инженеров, аналитиков, backend-разработчиков, техлидов и тех, кто работает с data-командами и хочет лучше понимать современный стек DE📌 Что внутри:– 10 недель обучения– 30 занятий: онлайн + записи– 10 практических лабораторных работ– облачный кластер и реальные данные– чат участников и поддержка команды программы📌 Что получите на выходе:1. Научитесь решать типовые задачи DE на практике2. Систематизируете знания и закроете пробелы в современном DE-стеке3. Поработаете с реальными данными и инфраструктурой, а не только с учебными примерами4. Соберете практический опыт, который можно обсуждать …

1 month, 1 week назад @ t.me
Мой первый эксперимент с созданием анимированных интерактивных роликов с помощью нейросетейВажный момент, что это не генеративное видео, а html-анимация. Получается что-то вроде того как раньше делали мультики на технологии Flash (если кто помнит Масяню —

Мой первый эксперимент с созданием анимированных интерактивных роликов с помощью нейросетейВажный момент, что это не генеративное видео, а html-анимация. Получается что-то вроде того как раньше делали мультики на технологии Flash (если кто помнит Масяню — она как раз на Flash)Всё рендерится в одной html-страничке весом 110 килобайтИспользовал Claude Code, модель Opus 5.5 в режиме Ultracode. На генерацию ушло 46 млн токенов. Это 119$ по расценкам API Claude, но у меня Max подписка за 100$ и поэтому всё влезло в одно окно сессии (на удивление)На моей стороне — сценарий, описание работы интерактивов, описание сеттинга. Остальное (в том числе выбор технологического стека) — работа Claude CodeМу…

1 month, 1 week назад @ t.me
Стать аналитиком данных всего за 10 недель — это реально!Если вы давно смотрите в сторону аналитики или хотите войти в профессию системно, а не одной ногой — сейчас самый подходящий момент.Симулейтив — школа аналитики, где обучают через практику и реальные
Стать аналитиком данных всего за 10 недель — это реально!Если вы давно смотрите в сторону аналитики или хотите войти в профессию системно, а не одной ногой — сейчас самый подходящий момент.Симулейтив — школа аналитики, где обучают через практику и реальные Стать аналитиком данных всего за 10 недель — это реально!Если вы давно смотрите в сторону аналитики или хотите войти в профессию системно, а не одной ногой — сейчас самый подходящий момент.Симулейтив — школа аналитики, где обучают через практику и реальные

Стать аналитиком данных всего за 10 недель — это реально!Если вы давно смотрите в сторону аналитики или хотите войти в профессию системно, а не одной ногой — сейчас самый подходящий момент.Симулейтив — школа аналитики, где обучают через практику и реальные кейсы, запускает абсолютно новый курс-буткемп - Профессия «Аналитик данных». Курс разделен на 2 этапа, за первые 10 недель вы обучаетесь аналитике и доходите до уровня junior-специалиста. А на втором этапе проходит углубленное изучение, где изучаете продвинутые инструменты и новые навыки. Что вас ждет на курсе: ➖SQL, Python, BI (Metabase + Power BI), статистика, A/B-тесты и продуктовые метрики;➖Живые занятия с ментором каждую неделю — не …

1 month, 1 week назад @ t.me
Команда DevCrowd запустила ежегодное исследование специалистов по работе с данными.*В этом году фокус на том, как меняется профессия: что AI реально сделал с составом работы, где проходят границы между дата-сайентистом, ML- и MLOps-инженером, что происходи
Команда DevCrowd запустила ежегодное исследование специалистов по работе с данными.*В этом году фокус на том, как меняется профессия: что AI реально сделал с составом работы, где проходят границы между дата-сайентистом, ML- и MLOps-инженером, что происходи Команда DevCrowd запустила ежегодное исследование специалистов по работе с данными.*В этом году фокус на том, как меняется профессия: что AI реально сделал с составом работы, где проходят границы между дата-сайентистом, ML- и MLOps-инженером, что происходи

Команда DevCrowd запустила ежегодное исследование специалистов по работе с данными.*В этом году фокус на том, как меняется профессия: что AI реально сделал с составом работы, где проходят границы между дата-сайентистом, ML- и MLOps-инженером, что происходит с порогом входа в профессию и рынком труда.Часть вопросов задается третий год подряд, что дает реальную динамику, а не просто срез.Опрос анонимный, 12–15 минут. В ноябре ребята опубликуют отчет со всеми данными, а также списками рекомендованных телеграм-каналов и курсов, собранными из ответов участников.Пройти опрос: https://survey.devcrowd.ru/data-2026*DevCrowd — это независимые исследования IT-профессий: 15 000+ участников, публичные о…

1 month, 1 week назад @ t.me
📊 Аналитик данных: системные знания для профессионального роста14 октября на Факультете компьютерных наук НИУ ВШЭ стартует программа профессиональной переподготовки «Аналитик данных». Программа охватывает ключевые направления работы с данными: от Python, S
📊 Аналитик данных: системные знания для профессионального роста14 октября на Факультете компьютерных наук НИУ ВШЭ стартует программа профессиональной переподготовки «Аналитик данных». Программа охватывает ключевые направления работы с данными: от Python, S 📊 Аналитик данных: системные знания для профессионального роста14 октября на Факультете компьютерных наук НИУ ВШЭ стартует программа профессиональной переподготовки «Аналитик данных». Программа охватывает ключевые направления работы с данными: от Python, S

📊 Аналитик данных: системные знания для профессионального роста14 октября на Факультете компьютерных наук НИУ ВШЭ стартует программа профессиональной переподготовки «Аналитик данных». Программа охватывает ключевые направления работы с данными: от Python, SQL и статистики до продуктовой аналитики, визуализации и машинного обучения.📚 В программе:• Python и SQL для анализа данных;• математика и статистика;• проверка гипотез и A/B-тестирование;• визуализация данных и BI;• продуктовая аналитика;• машинное обучение;• хранилища данных и основы работы с большими данными;• итоговый проект на основе реальной задачи.🎓 Главное о программе:• ФКН НИУ ВШЭ — один из ведущих факультетов России в области ком…

1 month, 1 week назад @ t.me
⚡ Почему аналитики данных так востребованы и как стать аналитиком в 2026 году? Большинство новичков совершают одну и ту же ошибку: учат всё подряд.SQL, Python, Power BI, статистика… Но работодатели оценивают кандидатов не только по базовым навыкам, но и по
⚡ Почему аналитики данных так востребованы и как стать аналитиком в 2026 году? Большинство новичков совершают одну и ту же ошибку: учат всё подряд.SQL, Python, Power BI, статистика… Но работодатели оценивают кандидатов не только по базовым навыкам, но и по ⚡ Почему аналитики данных так востребованы и как стать аналитиком в 2026 году? Большинство новичков совершают одну и ту же ошибку: учат всё подряд.SQL, Python, Power BI, статистика… Но работодатели оценивают кандидатов не только по базовым навыкам, но и по

⚡ Почему аналитики данных так востребованы и как стать аналитиком в 2026 году? Большинство новичков совершают одну и ту же ошибку: учат всё подряд.SQL, Python, Power BI, статистика… Но работодатели оценивают кандидатов не только по базовым навыкам, но и по другим критериям. Из-за этого многие месяцами рассылают резюме и получают только отказы или полное игнорирование.Андрон Алексанян - аналитик с опытом 9 лет и СEO Симулейтив проведет бесплатный урок и покажет, как выглядит путь к первой работе аналитиком в 2026 году.Вы узнаете:🔶Какие навыки действительно проверяют на собеседованиях;🔶Что должно быть в портфолио, чтобы его открывали работодатели;🔶Почему многие резюме аналитиков сразу отправл…

1 month, 3 weeks назад @ t.me
Айтишники, горит вакансия ❗️ Позиция: Дата-аналитик Компания: Яндекс.Маркет Зарплата: 200,000-350,000₽ Кто хочет устроиться на такую позицию? Но в голове звучит: «Не вывезу» — скиллов ещё не хватает, ответственность слишком большая Один товарищ — Ваня, д

Айтишники, горит вакансия ❗️ Позиция: Дата-аналитик Компания: Яндекс.Маркет Зарплата: 200,000-350,000₽ Кто хочет устроиться на такую позицию? Но в голове звучит: «Не вывезу» — скиллов ещё не хватает, ответственность слишком большая Один товарищ — Ваня, для…

1 month, 3 weeks назад @ t.me
Айтишники, горит вакансия ❗️Позиция: Дата-аналитикКомпания: Яндекс.МаркетЗарплата: 200,000-350,000₽Кто хочет устроиться на такую позицию? Но в голове звучит: «Не вывезу» — скиллов ещё не хватает, ответственность слишком большаяОдин товарищ — Ваня, для вас
Айтишники, горит вакансия ❗️Позиция: Дата-аналитикКомпания: Яндекс.МаркетЗарплата: 200,000-350,000₽Кто хочет устроиться на такую позицию? Но в голове звучит: «Не вывезу» — скиллов ещё не хватает, ответственность слишком большаяОдин товарищ — Ваня, для вас Айтишники, горит вакансия ❗️Позиция: Дата-аналитикКомпания: Яндекс.МаркетЗарплата: 200,000-350,000₽Кто хочет устроиться на такую позицию? Но в голове звучит: «Не вывезу» — скиллов ещё не хватает, ответственность слишком большаяОдин товарищ — Ваня, для вас

Айтишники, горит вакансия ❗️Позиция: Дата-аналитикКомпания: Яндекс.МаркетЗарплата: 200,000-350,000₽Кто хочет устроиться на такую позицию? Но в голове звучит: «Не вывезу» — скиллов ещё не хватает, ответственность слишком большаяОдин товарищ — Ваня, для вас дюжину раз доказал, что даже с базовыми знаниями о Python ты можешь претендовать на такую зарплату хоть этой веснойОн сам работал продуктовым аналитиком в крупных компаниях и в блоге делится инфой, которую не расскажет ни один коллега:- Как уверенно проходить собеседования? [Полный гайд]- Какие ошибки не позволяют тебе получать офферы от 250,000₽? [Читать]- Разборы задач с ваших будущих собеседований [Открыть]Кто сохранит канал сейчас — за…

1 month, 4 weeks назад @ t.me
⚡️Вышло новое исследование «AI в BI Круг Громова 2026»!ИИ в бизнес-аналитике выходит за пределы обычного чат-помощника. Следующий этап – агентная аналитика и переход от модели «вопрос–ответ» к модели «задача–результат»: ИИ не просто отвечает на отдельный з
⚡️Вышло новое исследование «AI в BI Круг Громова 2026»!ИИ в бизнес-аналитике выходит за пределы обычного чат-помощника. Следующий этап – агентная аналитика и переход от модели «вопрос–ответ» к модели «задача–результат»: ИИ не просто отвечает на отдельный з ⚡️Вышло новое исследование «AI в BI Круг Громова 2026»!ИИ в бизнес-аналитике выходит за пределы обычного чат-помощника. Следующий этап – агентная аналитика и переход от модели «вопрос–ответ» к модели «задача–результат»: ИИ не просто отвечает на отдельный з

⚡️Вышло новое исследование «AI в BI Круг Громова 2026»!ИИ в бизнес-аналитике выходит за пределы обычного чат-помощника. Следующий этап – агентная аналитика и переход от модели «вопрос–ответ» к модели «задача–результат»: ИИ не просто отвечает на отдельный запрос, а самостоятельно планирует анализ, ищет нужные данные и инструменты, выстраивает многошаговую цепочку и выполняет действия.В отчет «AI в BI-круг Громова 2026» вошли более 10 российских BI-решений с поддержкой AI-функций, среди которых: Yandex DataLens, Навигатор BI, Insight SOLARIS, PIX BI, Easy Report, DataForge AI, Glarus AI, Visiology Cortex, Luxms AI, Polyanalyst и ТЕРН ИИ Ассистент. Решения при этом разделены на 4 архитектурных…

1 month, 4 weeks назад @ t.me
Труба данных Труба данных
последний пост 7 months назад
💎ЗАКРЫТОЕ КОММЬЮНИТИ В СФЕРЕ АРБИТРАЖА КРИПТОВАЛЮТВыплаты от $3.000 в месяц и более (в зависимости от оборота) Первая выплата — через 3 дня - Предоставляем обучение, личные кураторы - Набор без опыта — выгодные условия для наших трейдеров - Команда №1 на р
💎ЗАКРЫТОЕ КОММЬЮНИТИ В СФЕРЕ АРБИТРАЖА КРИПТОВАЛЮТВыплаты от $3.000 в месяц и более (в зависимости от оборота) Первая выплата — через 3 дня - Предоставляем обучение, личные кураторы - Набор без опыта — выгодные условия для наших трейдеров - Команда №1 на р 💎ЗАКРЫТОЕ КОММЬЮНИТИ В СФЕРЕ АРБИТРАЖА КРИПТОВАЛЮТВыплаты от $3.000 в месяц и более (в зависимости от оборота) Первая выплата — через 3 дня - Предоставляем обучение, личные кураторы - Набор без опыта — выгодные условия для наших трейдеров - Команда №1 на р

💎ЗАКРЫТОЕ КОММЬЮНИТИ В СФЕРЕ АРБИТРАЖА КРИПТОВАЛЮТВыплаты от $3.000 в месяц и более (в зависимости от оборота) Первая выплата — через 3 дня - Предоставляем обучение, личные кураторы - Набор без опыта — выгодные условия для наших трейдеров - Команда №1 на рынке — присоединяйся и работай по лучшим связкам- Свободный график🔗Присоединиться - https://wavium.ru⚙️ Наш бот - https://t.me/waviumbot⚡️ПОДАТЬ ЗАЯВКУ⚡️ПОДАТЬ ЗАЯВКУ⚡️ПОДАТЬ ЗАЯВКУ

7 months назад @ telegram.me
💎ЗАКРЫТОЕ КОММЬЮНИТИ В СФЕРЕ АРБИТРАЖА КРИПТОВАЛЮТВыплаты от $3.000 в месяц и более (в зависимости от оборота) Первая выплата — через 3 дня - Предоставляем обучение, личные кураторы - Набор без опыта — выгодные условия для наших трейдеров - Команда №1 на р
💎ЗАКРЫТОЕ КОММЬЮНИТИ В СФЕРЕ АРБИТРАЖА КРИПТОВАЛЮТВыплаты от $3.000 в месяц и более (в зависимости от оборота) Первая выплата — через 3 дня - Предоставляем обучение, личные кураторы - Набор без опыта — выгодные условия для наших трейдеров - Команда №1 на р 💎ЗАКРЫТОЕ КОММЬЮНИТИ В СФЕРЕ АРБИТРАЖА КРИПТОВАЛЮТВыплаты от $3.000 в месяц и более (в зависимости от оборота) Первая выплата — через 3 дня - Предоставляем обучение, личные кураторы - Набор без опыта — выгодные условия для наших трейдеров - Команда №1 на р

💎ЗАКРЫТОЕ КОММЬЮНИТИ В СФЕРЕ АРБИТРАЖА КРИПТОВАЛЮТВыплаты от $3.000 в месяц и более (в зависимости от оборота) Первая выплата — через 3 дня - Предоставляем обучение, личные кураторы - Набор без опыта — выгодные условия для наших трейдеров - Команда №1 на рынке — присоединяйся и работай по лучшим связкам- Свободный график🔗Присоединиться - https://wavium.ru⚙️ Наш бот - https://t.me/waviumbot⚡️ПОДАТЬ ЗАЯВКУ⚡️ПОДАТЬ ЗАЯВКУ⚡️ПОДАТЬ ЗАЯВКУ

7 months назад @ t.me
Channel created
Channel created

Channel created

7 months назад @ telegram.me
Channel created
Channel created

Channel created

7 months назад @ t.me
Обычно по пятница выходит пятничный юмор, но сегодня - крайняя шутка.Этот канал прослужил мне верой и правдой почти 6.5 лет и за это время подарил мне очень разнообразный опыт, 5 тысяч рублей донатов, вакансии и проекты и больше 4 тысяч людей, которым инте
Обычно по пятница выходит пятничный юмор, но сегодня - крайняя шутка.Этот канал прослужил мне верой и правдой почти 6.5 лет и за это время подарил мне очень разнообразный опыт, 5 тысяч рублей донатов, вакансии и проекты и больше 4 тысяч людей, которым инте Обычно по пятница выходит пятничный юмор, но сегодня - крайняя шутка.Этот канал прослужил мне верой и правдой почти 6.5 лет и за это время подарил мне очень разнообразный опыт, 5 тысяч рублей донатов, вакансии и проекты и больше 4 тысяч людей, которым инте

Обычно по пятница выходит пятничный юмор, но сегодня - крайняя шутка.Этот канал прослужил мне верой и правдой почти 6.5 лет и за это время подарил мне очень разнообразный опыт, 5 тысяч рублей донатов, вакансии и проекты и больше 4 тысяч людей, которым интересно мое мнение на тему, о существовании которой я узнал чисто случайно 7 лет назад. Макс, ты помнишь как ты мне сказал "Так ты ведь получается занимаешься дата инжинирингом?" 😃Я безумно благодарен вам всем за то, что приходили в комменты и писали свое мнение, за бесконечное количество 💩 оставленных под постами, за репосты и материал, который вы приносили. Я смотрю на этот путь, который мы прошли с вами и я вам очень благодарен!По количес…

8 months, 1 week назад @ t.me
https://clickhouse.com/blog/clickhouse-kubernetes-operatorКликхаус выкатил K8S Operator. Это чтобы было изи раскатить клик в кубере.Да-да, давайте не будем базы данных держать в кубернетесе, только bare metal и весь остальной бубнеж.Большинству компаний бу

https://clickhouse.com/blog/clickhouse-kubernetes-operatorКликхаус выкатил K8S Operator. Это чтобы было изи раскатить клик в кубере.Да-да, давайте не будем базы данных держать в кубернетесе, только bare metal и весь остальной бубнеж.Большинству компаний будет достаточно и клика в кубере. (хотя, если честно, таким компаниям, наверное, рано в кубер)@ohmydataengineer

9 months, 1 week назад @ t.me
enthusiastech enthusiastech
последний пост None
data будни data будни
последний пост 2 days, 12 hours назад
🤖 в левой руке кодекс, в правой руке — клодкажется я тут потихоньку эволюционировал (?) в промпт инженера: последние ~полгода мой основной инструмент не иде, а окно с агентами: сначала это был курсор, потом клод-код, потом клод и кодекс в параллель.начинал

🤖 в левой руке кодекс, в правой руке — клодкажется я тут потихоньку эволюционировал (?) в промпт инженера: последние ~полгода мой основной инструмент не иде, а окно с агентами: сначала это был курсор, потом клод-код, потом клод и кодекс в параллель.начиналось всё как просто дополнение строки, потом простые функции. потом перешли на «напиши новый етл-модуль». сейчас на этапе «вот тебе тикет, разберись что там такое, предложи решение и имплементируй; отпиши результат»постепенно эти нейро-ребята взяли на себя всю рутину: парсят за меня рабочий трекер и интранет за последней информацией, собирают сводки бест-практик по внешней сети и, конечно, решают задачки — пишут код и помогают придумывать а…

2 days, 12 hours назад @ t.me
🤩 delirious dhhитак, прослушал ~5ч одного небезызвестного программиста с сильными взглядами; ушло у меня на это всего где-то неделя: пара походов в спортзал и комьютов.чем примечательно это интервью?во-первых, dhh известен своими взглядами за чистоту кода

🤩 delirious dhhитак, прослушал ~5ч одного небезызвестного программиста с сильными взглядами; ушло у меня на это всего где-то неделя: пара походов в спортзал и комьютов.чем примечательно это интервью?во-первых, dhh известен своими взглядами за чистоту кода; это тот ещё художник и скульптор, который «вручную вытачивал» каждый кусочек своих программ. за свою карьеру с 90х он успел понабраться и опыта, и мненийво-вторых, не далее чем год назад, тот же самый dhh приходил в тот же подскаст и уверял, что этим вашим агентам ещё довольно далеко до настоящего года: так — автокомплит, не более!получается такой идеальный маркер для 2025-26 годов - даже самые сильные программисты стали признавать возрос…

1 month, 1 week назад @ t.me
мне кажется последние два интервью отлично смотрятся вместе и дополняют друг друга >_>и отдельно мысль, которая где-то проговаривалась в этих интервью: токены — новый вид бенефита для сотрудников. большие компании готовы вливать миллионы в токены для
мне кажется последние два интервью отлично смотрятся вместе и дополняют друг друга &gt;_&gt;и отдельно мысль, которая где-то проговаривалась в этих интервью: токены — новый вид бенефита для сотрудников. большие компании готовы вливать миллионы в токены для

мне кажется последние два интервью отлично смотрятся вместе и дополняют друг друга >_>и отдельно мысль, которая где-то проговаривалась в этих интервью: токены — новый вид бенефита для сотрудников. большие компании готовы вливать миллионы в токены для своих разработчиков. а сами поставщики фундаментальных моделей в принципе ограничены только внутренними мощностями для своих сотрудников.в подкастах Кирилла Мокевнина @orgprog упоминали, что в долине у каждого второго безлимит на модели OpenAI / Anthropic по тем или иным каналам

6 months, 3 weeks назад @ telegram.me
мне кажется последние два интервью отлично смотрятся вместе и дополняют друг друга >_>и отдельно мысль, которая где-то проговаривалась в этих интервью: токены — новый вид бенефита для сотрудников. большие компании готовы вливать миллионы в токены для
мне кажется последние два интервью отлично смотрятся вместе и дополняют друг друга &gt;_&gt;и отдельно мысль, которая где-то проговаривалась в этих интервью: токены — новый вид бенефита для сотрудников. большие компании готовы вливать миллионы в токены для

мне кажется последние два интервью отлично смотрятся вместе и дополняют друг друга >_>и отдельно мысль, которая где-то проговаривалась в этих интервью: токены — новый вид бенефита для сотрудников. большие компании готовы вливать миллионы в токены для своих разработчиков. а сами поставщики фундаментальных моделей в принципе ограничены только внутренними мощностями для своих сотрудников.в подкастах Кирилла Мокевнина @orgprog упоминали, что в долине у каждого второго безлимит на модели OpenAI / Anthropic по тем или иным каналам

6 months, 3 weeks назад @ t.me
🥷 DHH об agent-first подходеDHH — известный ии-скептик и сторонник написания кода вручную; в своём сетапе он не использует IDE с их подсказками и навигацией по коду — всё набивает ручками (и радуется)ещё DHH известен своими сильным мнением и радикальными в

🥷 DHH об agent-first подходеDHH — известный ии-скептик и сторонник написания кода вручную; в своём сетапе он не использует IDE с их подсказками и навигацией по коду — всё набивает ручками (и радуется)ещё DHH известен своими сильным мнением и радикальными взглядами — он говорит что думает, не взирая на мнения большинства или отдельных авторитетовнедавно зашёл к Pragmatic Engineer на интервьюhttps://youtu.be/JiWgKRgdgpIи вот наступил действительно переломный момент: ⁃ июль 2025 — DHH не верит и не использует агентов ⁃ январь 2026 — DHH переходит на agent-first разработку что поменялось? вышли модели, которые выдают достаточно хороший результат, которые при минимальных доработках можно шипать …

6 months, 3 weeks назад @ telegram.me
🥷 DHH об agent-first подходеDHH — известный ии-скептик и сторонник написания кода вручную; в своём сетапе он не использует IDE с их подсказками и навигацией по коду — всё набивает ручками (и радуется)ещё DHH известен своими сильным мнением и радикальными в

🥷 DHH об agent-first подходеDHH — известный ии-скептик и сторонник написания кода вручную; в своём сетапе он не использует IDE с их подсказками и навигацией по коду — всё набивает ручками (и радуется)ещё DHH известен своими сильным мнением и радикальными взглядами — он говорит что думает, не взирая на мнения большинства или отдельных авторитетовнедавно зашёл к Pragmatic Engineer на интервьюhttps://youtu.be/JiWgKRgdgpIи вот наступил действительно переломный момент: ⁃ июль 2025 — DHH не верит и не использует агентов ⁃ январь 2026 — DHH переходит на agent-first разработку что поменялось? вышли модели, которые выдают достаточно хороший результат, которые при минимальных доработках можно шипать …

6 months, 3 weeks назад @ t.me
🦄 руководитель Claude Code об AI в разработкепослушал интервью Бориса Чёрного в подкасте Ленни. Борис написал первую версию Claude Code и теперь руководит этим направлением в Anthropic.https://youtu.be/We7BZVKbCVwпо их данным сейчас уже 4% всех коммитов в

🦄 руководитель Claude Code об AI в разработкепослушал интервью Бориса Чёрного в подкасте Ленни. Борис написал первую версию Claude Code и теперь руководит этим направлением в Anthropic.https://youtu.be/We7BZVKbCVwпо их данным сейчас уже 4% всех коммитов в Гитхаб создаются через Claude Code (ожидают 20% к концу года)интересно, что первую версию Claude Code Борис сделал прошлой весной и это не был сиюминутный успех; популярность инструмента росла постепенно и взрывной рост случился после выхода модели осенью (Опус 4.5 кажется)и с ноября 2025 Борис не написал ни строчки кода вручную — всё через Клода; так же приводит в пример «лучших программистов Spotify», мол, они тоже больше не пишут код ру…

6 months, 3 weeks назад @ telegram.me
🦄 руководитель Claude Code об AI в разработкепослушал интервью Бориса Чёрного в подкасте Ленни. Борис написал первую версию Claude Code и теперь руководит этим направлением в Anthropic.https://youtu.be/We7BZVKbCVwпо их данным сейчас уже 4% всех коммитов в

🦄 руководитель Claude Code об AI в разработкепослушал интервью Бориса Чёрного в подкасте Ленни. Борис написал первую версию Claude Code и теперь руководит этим направлением в Anthropic.https://youtu.be/We7BZVKbCVwпо их данным сейчас уже 4% всех коммитов в Гитхаб создаются через Claude Code (ожидают 20% к концу года)интересно, что первую версию Claude Code Борис сделал прошлой весной и это не был сиюминутный успех; популярность инструмента росла постепенно и взрывной рост случился после выхода модели осенью (Опус 4.5 кажется)и с ноября 2025 Борис не написал ни строчки кода вручную — всё через Клода; так же приводит в пример «лучших программистов Spotify», мол, они тоже больше не пишут код ру…

6 months, 3 weeks назад @ t.me
📁 про культуру ведения тикетовпродолжаю рассказывать про внутрянку нашей команды, привлекая ваше внимание к активным вакансиям >_>> важный дисклеймер: это не я, это всё наш техлид Кирилл (я тут только документирую и выношу)думаю, все видели тикеты
📁 про культуру ведения тикетовпродолжаю рассказывать про внутрянку нашей команды, привлекая ваше внимание к активным вакансиям &gt;_&gt;&gt; важный дисклеймер: это не я, это всё наш техлид Кирилл (я тут только документирую и выношу)думаю, все видели тикеты

📁 про культуру ведения тикетовпродолжаю рассказывать про внутрянку нашей команды, привлекая ваше внимание к активным вакансиям >_>> важный дисклеймер: это не я, это всё наш техлид Кирилл (я тут только документирую и выношу)думаю, все видели тикеты, прочитав которые, осталось непонятным что́ надо сделать; или задачи, где ты вроде сделал что было написано, но оказалось, что нужно было не то и не так ¯\_(ツ)_/¯ мы в команде стараемся придерживаться культуры ведения задач — попробую описать как я это вижу⌘⌘⌘начнём с того, что создать хороший тикет - это отдельная работа; чтобы понятно описать что надо сделать, надо как минимум представлять проблему и целевое решениеесть базовый паттерн, которого …

9 months, 1 week назад @ t.me
📁 про культуру ведения тикетовпродолжаю рассказывать про внутрянку нашей команды, привлекая ваше внимание к активным вакансиям >_>> важный дисклеймер: это не я, это всё наш техлид Кирилл (я тут только документирую и выношу)думаю, все видели тикеты
📁 про культуру ведения тикетовпродолжаю рассказывать про внутрянку нашей команды, привлекая ваше внимание к активным вакансиям &gt;_&gt;&gt; важный дисклеймер: это не я, это всё наш техлид Кирилл (я тут только документирую и выношу)думаю, все видели тикеты

📁 про культуру ведения тикетовпродолжаю рассказывать про внутрянку нашей команды, привлекая ваше внимание к активным вакансиям >_>> важный дисклеймер: это не я, это всё наш техлид Кирилл (я тут только документирую и выношу)думаю, все видели тикеты, прочитав которые, осталось непонятным что́ надо сделать; или задачи, где ты вроде сделал что было написано, но оказалось, что нужно было не то и не так ¯\_(ツ)_/¯ мы в команде стараемся придерживаться культуры ведения задач — попробую описать как я это вижу⌘⌘⌘начнём с того, что создать хороший тикет - это отдельная работа; чтобы понятно описать что надо сделать, надо как минимум представлять проблему и целевое решениеесть базовый паттерн, которого …

9 months, 1 week назад @ telegram.me
🦀 Clawdbot / Moltbot / OpenClaw там похоже намечается очередной качественный скачок аи-строения: австрийский программист написал автономного (?) ии-агента… и понеслосьформат горячих новостей не мой любимый жанр, но это залетело в моё инфополе с трёх разных

🦀 Clawdbot / Moltbot / OpenClaw там похоже намечается очередной качественный скачок аи-строения: австрийский программист написал автономного (?) ии-агента… и понеслосьформат горячих новостей не мой любимый жанр, но это залетело в моё инфополе с трёх разных сторон:+ Самат Галимов накидал ссылок для понимания контекстаhttps://t.me/ctodaily/1995+ Pragmatic Engineer выпустил интервью с авторомhttps://youtu.be/8lF7HmQ_RgY+ ребята из Шмит16 собрались вместе где-то на Бали и скупают все доступные мак-мини, чтобы устроить ферму из таких аи-агентов сам автор бота не случайный мамкин вайбкодер — он начинал ещё с веб-приложений в начале 2000-х и потом перешёл на приложения айос для первого айфона. пот…

9 months, 1 week назад @ t.me
🦀 Clawdbot / Moltbot / OpenClaw там похоже намечается очередной качественный скачок аи-строения: австрийский программист написал автономного (?) ии-агента… и понеслосьформат горячих новостей не мой любимый жанр, но это залетело в моё инфополе с трёх разных

🦀 Clawdbot / Moltbot / OpenClaw там похоже намечается очередной качественный скачок аи-строения: австрийский программист написал автономного (?) ии-агента… и понеслосьформат горячих новостей не мой любимый жанр, но это залетело в моё инфополе с трёх разных сторон:+ Самат Галимов накидал ссылок для понимания контекстаhttps://t.me/ctodaily/1995+ Pragmatic Engineer выпустил интервью с авторомhttps://youtu.be/8lF7HmQ_RgY+ ребята из Шмит16 собрались вместе где-то на Бали и скупают все доступные мак-мини, чтобы устроить ферму из таких аи-агентов сам автор бота не случайный мамкин вайбкодер — он начинал ещё с веб-приложений в начале 2000-х и потом перешёл на приложения айос для первого айфона. пот…

9 months, 1 week назад @ telegram.me
data будни pinned «📢 ищем дата-коллег к себе в Яндекс Финтех → дата инженеры https://yandex.ru/jobs/vacancies/inzhener-dannih-v-finteh-36637 → дата-партнёры (они же системные аналитики двх) https://yandex.ru/jobs/vacancies/analitik-dwh-v-finteh-27815 эт

data будни pinned «📢 ищем дата-коллег к себе в Яндекс Финтех → дата инженеры https://yandex.ru/jobs/vacancies/inzhener-dannih-v-finteh-36637 → дата-партнёры (они же системные аналитики двх) https://yandex.ru/jobs/vacancies/analitik-dwh-v-finteh-27815 это прям в нашу команду…»

9 months, 1 week назад @ t.me
data будни pinned «📢 ищем дата-коллег к себе в Яндекс Финтех → дата инженеры https://yandex.ru/jobs/vacancies/inzhener-dannih-v-finteh-36637 → дата-партнёры (они же системные аналитики двх) https://yandex.ru/jobs/vacancies/analitik-dwh-v-finteh-27815 эт

data будни pinned «📢 ищем дата-коллег к себе в Яндекс Финтех → дата инженеры https://yandex.ru/jobs/vacancies/inzhener-dannih-v-finteh-36637 → дата-партнёры (они же системные аналитики двх) https://yandex.ru/jobs/vacancies/analitik-dwh-v-finteh-27815 это прям в нашу команду…»

9 months, 1 week назад @ telegram.me
✍️ о код-ревью у нас в команде в прод только через пулл-реквесты и каждый пулл-реквест должно посмотреть двое коллег. моя личная статистика за 2025 год показывает 430 проведённых код-ревью. сложились какие-то мысли по этому поводу, ниже пытаюсь собрать и

✍️ о код-ревью у нас в команде в прод только через пулл-реквесты и каждый пулл-реквест должно посмотреть двое коллег. моя личная статистика за 2025 год показывает 430 проведённых код-ревью. сложились какие-то мысли по этому поводу, ниже пытаюсь собрать их…

9 months, 1 week назад @ telegram.me
под капотом Яндекс.Такси под капотом Яндекс.Такси
последний пост None
🎧 Podcasts
Data Engineering Podcast Data Engineering Podcast
последний пост None
Data Brew by Databricks
последний пост None
«Ничего такого» by Dodo Enginnering
последний пост None
Запуск завтра Podcast Запуск завтра Podcast
последний пост 4 days, 14 hours назад
Как меньше залипать? Неэкспертные советы от людей, которые много времени проводят в телефонах

Если вы много раз пытались сократить экранное время и у вас ничего не получалось — поздравляем, вы не одиноки. В этом эпизоде Самат и техножурналист и стартапер Султан Сулейманов обсуждают, как пробовали разные способы перестать залипать. Спойлер: большинство из них не сработало. Но и удачные решения тоже есть! Здоровые отношения с гаджетами мы вам не обещаем, но честно расскажем, что можно сделать, если хочется проводить меньше времени у экранов, а совсем отказываться от технологий не хочется.Чтобы проверка инвестора или аудитора не превратилась в раскопки, оформляйте подрядчиков через 4dev.com - демо по ссылке: https://4dev.com/promo/?utm_source=influencer&utm_medium=podcast&utm_campaign=…

4 days, 14 hours назад @ share.transistor.fm
Почему все заговорили об ИИ-апокалипсисе

Ведущие ИИ-лаборатории всерьез бьют тревогу и призывают замедлить разработку моделей из опасения, что они выйдут из-под контроля. Откуда берутся страшные прогнозы? Что предлагают ученые и разработчики? Как понять, где реальная угроза, а где — необоснованная паника? Разбираемся вместе с Артемом Родичевым — человеком из индустрии, который занимается искусственным интеллектом больше десяти лет.Упростите оформление подрядчиков и храните документы в порядке вместе с 4dev.com: https://4dev.com/promo/?utm_source=influencer&utm_medium=podcast&utm_campaign=podcast_2026&utm_content=LaunchtomorrowaudioМатериалы из эпизода:AI 2027 https://ai-2027.com/AI 2040 https://ai-2040.com/⏳ Следующий выпуск уже м…

1 week, 4 days назад @ share.transistor.fm
Как дата-центры влияют на экологию

Кажется, что искусственный интеллект и облачные технологии — это нечто нематериальное, «чистое» и почти бесплатное. Но каждый раз, когда вы спрашиваете нейросеть, что лучше приготовить на ужин или как ответить на неприятное письмо, где-то в мире тратится энергия — для работы дата-центров. За прошлый год они сожгли электричества как целая Франция — страна с населением почти 70 миллионов человек.В этом выпуске подкаста «Запуск завтра» мы разбираемся в скрытой цене искусственного интеллекта. Наша гостья — Ольга Добровидова, научная журналистка с 15-летним стажем, которая помогает разобраться в сложных историях о науке и технологиях. Мы поговорили о дата-центрах — тех самых «фабриках облаков», …

2 months, 1 week назад @ share.transistor.fm
Чем мы платим за ИИ
Чем мы платим за ИИ Чем мы платим за ИИ

Каждый раз, когда вы спрашиваете нейросеть, что лучше приготовить на ужин или как ответить на неприятное письмо, где-то в мире тратится электричество — на работу серверов и дата-центров. За прошлый год они сожгли электричества примерно как целая Франция. Но действительно ли это проблема? Зачем вообще дата-центрам столько ресурсов? И как это в итоге влияет на нашу жизнь? Самат Галимов говорит с научной журналисткой Ольгой Добровидовой.Подписывайтесь на Либо/Либо+! В честь семилетия нашей студии годовая подписка стоит всего 2495 рублей. Подписывайтесь в Telegram: https://cutt.ly/zap3108eptg и в Apple Podcasts https://cutt.ly/zap3108epapЧат Запуска в телеграме: https://t.me/zapuskzavtraБот наш…

2 months, 3 weeks назад @ share.transistor.fm
Как нейросети помогают ученым искать новые лекарства и делать открытия
Как нейросети помогают ученым искать новые лекарства и делать открытия Как нейросети помогают ученым искать новые лекарства и делать открытия

Это межсезонный эпизод «Запуск завтра». В нем — скрининг миллионов молекул, нейросети для поиска активных сперматозоидов и изучение щелчков кашалотов. Мы позвали научного обозревателя Илью Колмановского, чтобы узнать, как ИИ приходит в науку и почему для ученых это — обоюдоострый нож.Подписывайтесь на Либо/Либо+! В честь семилетия нашей студии годовая подписка стоит всего 2495 рублей. Подписывайтесь в Telegram: https://cutt.ly/don24bttg и в Apple Podcasts https://cutt.ly/don24btap28 июля старт курса по нарративным подкастам: https://course.libolibo.ru/podcast-narrative-course По промокоду ЗАПУСК — скидка 10%.Слушайте подкаст «Голый землекоп». Эпизоды, упомянутые в разговоре: «Зачем нужна ме…

3 months, 3 weeks назад @ share.transistor.fm
Венчур. Как инвесторы решают, во что вложить деньги
Венчур. Как инвесторы решают, во что вложить деньги Венчур. Как инвесторы решают, во что вложить деньги

Правда, что если в названии стартапа есть слово «искусственный интеллект», то в него не глядя вложат деньги? В этом выпуске венчурный инвестор из Долины Николай Давыдов простым языком объясняет, как устроена индустрия. А ещё — какие красные флаги бывают у стартапов, как он на самом старте понял, что надо вкладываться в Perplexity — сейчас это один из самых дорогих ИИ-стартапов в мире, и почему компании для инвестиций нужно выбирать серьёзнее, чем женуРеклама. Рекламодатель АО «Селектел». erid: 2SDnjdAKTeaSelectel — независимый провайдер, который поможет построить надежную и гибкую ИТ-инфраструктуру для проектов разной сложности, в том числе для масштабных задач: https://slc.tl/6n7x8⚡️ У это…

4 months, 2 weeks назад @ share.transistor.fm
Как работают носимые устройства и нужны ли они вам

Умные часы, умные браслеты, умные кольца — наверняка ваши знакомые или вы сами задумывались о покупке таких устройств. Производители убеждают, что помогут вам на пути к здоровью и высокому качеству жизни. Но что на самом деле умеют такие девайсы? Кому они реально полезны, а для кого — дорогая игрушка? На что обращать внимание при выборе? В этом эпизоде мы разбираемся, стоит ли вам тратить деньги на еще один гаджет, а помогает нам в этом Татьяна Гатинская. Татьяна много лет занималась медицинскими изделиями в фармацевтической компании Novartis, а сейчас вместе с командой создает свое носимое устройство. Реклама. Рекламодатель АО «Селектел». erid: 2SDnjeBdxkrSelectel — независимый провайдер, …

4 months, 3 weeks назад @ share.transistor.fm
Космические планы. Что еще нам может дать космос и зачем так часто туда летать

Помните, когда каждый полет в космос был большим событием? Теперь пусками как будто никого не удивишь — в новостях постоянно пишут, что Илон Маск с его компанией SpaceX опять что-то запустили. Зачем отправлять в космос так много ракет? Какие безумные планы строят самые крупные игроки космической индустрии? И почему это все касается нас, простых людей на Земле? Вместе с аналитиком ракетных пусков Георгием Тришкиным разбираемся, для чего нам космос и какого развития мы ожидаем в ближайшие годы.Реклама. Рекламодатель АО «Селектел». erid: 2SDnje1D24zSelectel — независимый провайдер, который поможет построить надежную и гибкую ИТ-инфраструктуру для проектов разной сложности, в том числе для масш…

5 months назад @ share.transistor.fm
Как меняется кибербезопасность с ИИ

Нейросети научились находить уязвимости. Что это значит для разработчиков и обычных пользователей? Станет ли проще атаковать и сложнее защищаться? Вместе с главным экспертом из Лаборатории Касперского Сергеем Головановым разбираемся, как меняется индустрия, когда и хакеры, и безопасники вооружились искусственным интеллектом.Реклама. Рекламодатель АО «Селектел». erid: 2SDnjeiSCq8Selectel — независимый провайдер, который поможет построить надежную и гибкую ИТ-инфраструктуру для проектов разной сложности, в том числе для масштабных задач: https://slc.tl/97prs⚡️ У этого выпуска есть видеоверсия! Посмотрите ее на нашем YouTube-канале: https://www.youtube.com/@launchtomorrow Будем очень благодарн…

5 months, 1 week назад @ share.transistor.fm
Как создаются современные чипы
Как создаются современные чипы Как создаются современные чипы

Чипы — это маленькие кремниевые пластинки внутри всех наших устройств. Без них не разогреется еда в микроволновке и не заведётся автомобиль — чипы нужны буквально везде. При этом их производство — настолько запутанный процесс, что удивительно, как он вообще работает. Сегодня мы разберёмся, как устроены современные чипы и почему в последние годы они подорожали. Поговорю я с Дианой Гришиной — она работала в ASML, единственной в мире компании, которая производит станки для создания самых крутых чипов.Реклама. Рекламодатель АО «Селектел». erid: 2SDnjcRXCVQSelectel — независимый провайдер, который поможет построить надежную и гибкую ИТ-инфраструктуру для проектов разной сложности, в том числе дл…

5 months, 2 weeks назад @ share.transistor.fm
Как живет российская гражданская авиация после санкций
Как живет российская гражданская авиация после санкций Как живет российская гражданская авиация после санкций

После февраля 2022 года российская гражданская авиация оказалась практически отрезана санкциями от остального мира. Запреты коснулись не только воздушного пространства, но и лизинга, регистрации и обслуживания самолетов. И это целиком поменяло работу авиакомпаний. Как теперь поддерживаются самолеты в России? Сможет ли авиация перейти на «отечественный флот»? Стало ли опаснее летать? Рассказывает Анастасия Дагаева, журналистка и независимый авиационный эксперт.Реклама. Рекламодатель АО «Селектел». erid: 2SDnjeXxtnNSelectel — независимый провайдер, который поможет построить надежную и гибкую ИТ-инфраструктуру для проектов разной сложности, в том числе для масштабных задач: https://slc.tl/m4hc…

5 months, 3 weeks назад @ share.transistor.fm
Как отношения с машиной влияют на человека
Как отношения с машиной влияют на человека Как отношения с машиной влияют на человека

В прошлом выпуске мы разбирались, как устроены эмоциональные ИИ-компаньоны под капотом. А в этом смотрим на отношения с ИИ с другой стороны. Опасно ли общаться с кем-то, кто не может сказать «нет»? Почему романтические отношения переоценены? И что делать родителям, если их ребёнок часами переписывается с ИИ? Самат Галимов говорит с семейным психологом и секс-терапевтом Мариной Травковой.Реклама. Рекламодатель АО «Селектел». erid: 2SDnjccwtV8Selectel — независимый провайдер, который поможет построить надежную и гибкую ИТ-инфраструктуру для проектов разной сложности, в том числе для масштабных задач: https://slc.tl/w0lq3 Сайт Марины Травковой: https://travkova.com/⚡️ У этого выпуска есть виде…

5 months, 4 weeks назад @ share.transistor.fm
Отношения с ИИ. Как устроены эмоциональные чат-боты
Отношения с ИИ. Как устроены эмоциональные чат-боты Отношения с ИИ. Как устроены эмоциональные чат-боты

Представьте, что вы достаёте телефон и видите новое уведомление. Собеседник в мессенджере спрашивает, как у вас дела, делится планами, шутит. Вы переписываетесь каждый день, иногда по несколько часов. А теперь представьте, что этот собеседник — не человек, а ИИ-компаньон, который настроен идеально под ваши потребности. Если вас это удивляет, вот ещё один факт: у сервисов с такими ботами уже миллионы пользователей и их популярность растёт. Как создаются эмоциональные ИИ-компаньоны? Какой персонаж среди них — звезда? И как работает эта индустрия? Самат Галимов говорит с Артёмом Родичевым, основателем платформы Ex-human.Реклама. Рекламодатель АО «Селектел». erid: 2SDnjejvUn6Selectel — независи…

6 months назад @ share.transistor.fm
ИИ для каждого. Как (и зачем) децентрализовать искусственный интеллект
ИИ для каждого. Как (и зачем) децентрализовать искусственный интеллект ИИ для каждого. Как (и зачем) децентрализовать искусственный интеллект

Искусственного интеллекта в нашей жизни станет только больше. При этом значительная часть вычислительных мощностей для него сосредоточена в руках нескольких крупных американских корпораций — Google, Microsoft, Amazon. Братья Даниил и Давид Либерманы считают, что такая централизация опасна, и строят альтернативную распределенную сеть по опыту Bitcoin. Этот эпизод — о борьбе с монополией на ИИ, мире с AGI и обществе изобилияРеклама. Рекламодатель АО «Селектел». erid: 2SDnjebM1xvSelectel — независимый провайдер, который поможет построить надежную и гибкую ИТ-инфраструктуру для проектов разной сложности, в том числе для масштабных задач: https://slc.tl/wkkak ⚡️ У этого выпуска есть видеоверсия!…

6 months, 1 week назад @ share.transistor.fm
Как подключить мозг к компьютеру
Как подключить мозг к компьютеру Как подключить мозг к компьютеру

Управление компьютером силой мысли — не научная фантастика. Лаборатории и стартапы по всему миру давно проводят эксперименты и разрабатывают интерфейсы, которые позволят миллионам людей пользоваться технологиями, минуя физические действия. Один из самых громких проектов в этой области — Neuralink Илона Маска; его пациентам вживляют датчики для считывания сигналов прямо в мозг. В этом выпуске кандидат биологических наук и руководитель группы нейрокогнитивных интерфейсов Сергей Шишкин рассказывает, как декодировать работу мозга, можно ли обойтись без инвазивных хирургических операций и на что способны нейротехнологии сегодня.Реклама. Рекламодатель АО «Селектел». erid: 2SDnjcR4GznSelectel — не…

6 months, 2 weeks назад @ share.transistor.fm
Moscow Python Podcast Moscow Python Podcast
последний пост 1 month, 1 week назад
x K2 Cloud. ИИ — экзоскелет для тимлида?

В гостях у Moscow Python Podcast Андрей Кулаев, руководитель группы инженеров разработки облака в K2 Cloud. Обсудили, как набрать команду AI-джунов и ускорить процессы с помощью вайбкодинга. Ведущие выпуска — сооснователь Moscow Python и aiaiai Валентин Домбровский, сооснователь aiaiai Георгий Мартиросов. aiaiai для разработчиков: https://getaiaiai.ru/solutions/developers/

Чат про ИИ в разработке: https://t.me/+dmaw8Z87z8E0ZmNi Ссылки выпуска:

Канал Moscow Python в Telegram - https://t.me/moscow_python

Митапы Moscow Python - https://moscowpython.ru

Канал Moscow Python на Rutube — https://rutube.ru/channel/45885590/

Канал Moscow Python в VK - https://vk.com/moscowpythonconf

Канал aiaiai в Te…

1 month, 1 week назад @ learnpython.podbean.com
Новости мира Python за август 2026

aiaiai для разработчиков — https://getaiaiai.ru/solutions/developers/

Ведущие – Григорий Петров и Михаил Корнеев Ссылки выпуска: Канал Миши в Telegram — https://t.me/tricky_python

Канал Moscow Python в Telegram — https://t.me/moscow_python

Все выпуски — https://podcast.python.ru

Митапы Moscow Python — https://moscowpython.ru

Канал Moscow Python на Rutube — https://rutube.ru/channel/45885590/

Канал Moscow Python в VK — https://vk.com/moscowpythonconf

1 month, 3 weeks назад @ learnpython.podbean.com
x Точка Банк. Зачем разработчику погружаться в продуктовый контекст

В гостях у Moscow Python Podcast Андрей Меркулов и Дмитрий Чуклай, тимлид и продакт в Точка Банке. Обсудили, где граница между ролями продакта и разработчика, как ИИ ускоряет релиз и стоит ли всецело доверять LLM. Ведущие выпуска — сооснователь Moscow Python и aiaiai Валентин Домбровский, сооснователь aiaiai Георгий Мартиросов. aiaiai для разработчиков: https://getaiaiai.ru/solutions/developers/

Чат про ИИ в разработке: https://t.me/+dmaw8Z87z8E0ZmNi Узнать больше о работе в IT-команде Точка Банк: https://tchk.me/tMZWPf (Страница откроется из Яндекс.Браузера или при установленном сертификате Минцифры) *Круг по холакратии — это контейнер для ролей, доменов, политик. Это группа ролей и людей …

1 month, 4 weeks назад @ learnpython.podbean.com
Новости мира Python за июль 2026

Ведущие – Григорий Петров и Михаил Корнеев

Новости выпуска: PEP 836: новый план развития JIT-компилятора для CPython — https://peps.python.org/pep-0836/ Ruff 0.16: теперь по умолчанию включены 413 правил вместо 59 — https://astral.sh/blog/ruff-v0.16.0 GitHub усиливает безопасность CI — https://github.blog/changelog/2026-07-28-dependabot-alerts-on-malicious-packages-across-more-ecosystems/ Релиз Django 6.1 — https://docs.djangoproject.com/en/6.1/releases/6.1/ Cтатья In Defense of Not Understanding Your Codebase — https://www.seangoedecke.com/in-defense-of-not-understanding-your-codebase/ Ссылки выпуска:

Курс Learn Python — https://learn.python.ru/advanced Канал Миши в Telegram — https://t.me…

3 months назад @ learnpython.podbean.com
Новости мира Python за июнь 2026

Ведущие – Григорий Петров и Михаил Корнеев

Новости выпуска: Что нового в Python 3.15 Beta — https://docs.python.org/3.15/whatsnew/3.15.html Django 6.1 Beta — https://docs.djangoproject.com/en/dev/releases/6.1/ PEP 835 – Shorthand syntax for Annotated type metadata — https://peps.python.org/pep-0835/ Are insecure code completions a vulnerability? — https://sethmlarson.dev/are-insecure-code-completions-a-vulnerability Ссылки выпуска:

Курс Learn Python — https://learn.python.ru/advanced Канал Миши в Telegram — https://t.me/tricky_python Канал Moscow Python в Telegram — https://t.me/moscow_python Все выпуски — https://podcast.python.ru Митапы Moscow Python — https://moscowpython.ru Канал Moscow…

3 months назад @ learnpython.podbean.com
Новости мира Python за май 2026

Ведущие – Григорий Петров и Михаил Корнеев

Новости выпуска: Steering consul дает команде JIT 6 месяцев, чтобы сделать PEP — https://discuss.python.org/t/an-announcement-from-the-steering-council-regarding-the-jit-project/107638 Два форка — httpx — https://tildeweb.nl/~michiel/httpx2.html PEP 661 – Sentinel Values — https://peps.python.org/pep-0661/ Любопытные результаты MOD_WSGI и free threading — https://grahamdumpleton.me/posts/2026/05/free-threading-vs-the-gil-in-mod-wsgi-6-0-0/ Жизнь до Github — https://lucumr.pocoo.org/2026/4/28/before-github/ Ссылки выпуска:

Курс Learn Python — https://learn.python.ru/advanced Канал Миши в Telegram — https://t.me/tricky_python Канал Moscow Python в Te…

4 months, 3 weeks назад @ learnpython.podbean.com
Новости мира Python за апрель 2026

Чтобы научиться программировать и разбираться в тонкостях Python 3.12 записывайтесь на базовый курс Learn Python — https://clck.ru/3MuShF Ведущие – Григорий Петров и Михаил Корнеев

Новости выпуска: Reverting the incremental GC in Python 3.14 and 3.15 — https://discuss.python.org/t/reverting-the-incremental-gc-in-python-3-14-and-3-15/107014 PEP 772 – Packaging Council governance process — https://peps.python.org/pep-0772/ What's new in pip 26.1 - lockfiles and dependency cooldowns — https://ichard26.github.io/blog/2026/04/whats-new-in-pip-26.1/ PyPI Security Best Practices — https://github.com/lirantal/pypi-security-best-practices Еще один package manager - pixi — https://codecut.ai/uv-pixi-…

6 months, 1 week назад @ learnpython.podbean.com
Новости мира Python за март 2026

Чтобы научиться программировать и разбираться в тонкостях Python 3.12 записывайтесь на базовый курс Learn Python — https://clck.ru/3MuShF Ведущие – Григорий Петров и Михаил Корнеев

Новости выпуска: Python 3.15’s JIT is now back on track — https://fidget-spinner.github.io/posts/jit-on-track.html OpenAI покупает Astral — https://openai.com/index/openai-to-acquire-astral/ JazzBand закрывается — https://jazzband.co/news/2026/03/14/sunsetting-jazzband Первый публичный релиз Django Modern Rest — https://github.com/wemake-services/django-modern-rest/releases/tag/0.1.0 Defense in Depth: A Practical Guide to Python Supply Chain Security — https://bernat.tech/posts/securing-python-supply-chain/ The S…

7 months назад @ learnpython.podbean.com
JS vs Python: сравнение экосистем на реальном проекте

Чтобы научиться программировать и разбираться в тонкостях Python 3.12 записывайтесь на базовый курс Learn Python — https://clck.ru/3MuShF

Ведущие – Григорий Петров и Михаил Корнеев Ссылки выпуска: Курс Learn Python — https://learn.python.ru/advanced

Канал Миши в Telegram — https://t.me/tricky_python

Канал Moscow Python в Telegram — https://t.me/moscow_python Все выпуски — https://podcast.python.ru

Митапы Moscow Python — https://moscowpython.ru

Канал Moscow Python на Rutube — https://rutube.ru/channel/45885590/

Канал Moscow Python в VK — https://vk.com/moscowpythonconf

7 months, 3 weeks назад @ learnpython.podbean.com
Новости мира Python за февраль 2026

Чтобы научиться программировать и разбираться в тонкостях Python 3.12 записывайтесь на базовый курс Learn Python — https://clck.ru/3MuShF Ведущие – Григорий Петров и Михаил Корнеев

Новости выпуска: Мейнтейнер httpx закрыл доступ к issues и discussions — https://github.com/encode/httpx/discussions/3784 Anthropic invests $1.5 million in the Python Software Foundation and open source security — https://pyfound.blogspot.com/2025/12/anthropic-invests-in-python.html Evolving Git for the next decade — https://lwn.net/Articles/1057561/ A CLI to fight GitHub spam — https://hugovk.dev/blog/2026/gh-triage/ Starlette 1.0.0rc1 — https://starlette.dev/release-notes/ Ссылки выпуска:

Курс Learn Python — ht…

8 months назад @ learnpython.podbean.com
Агентские системы от разработки до оценки

Чтобы научиться программировать и разбираться в тонкостях Python 3.12 записывайтесь на базовый курс Learn Python — https://clck.ru/3MuShF Ведущие – Григорий Петров и Михаил Корнеев Ссылки от Сергея: toloka.ai - компания

https://platform.toloka.ai/ - self service (быстрая разметка данных)

tendem.ai - Tendem (кентавр AI + human)

как начать работать в Толоке экспертом: https://mindrift.ai/apply Ссылки выпуска: Курс Learn Python — https://learn.python.ru/advanced Канал Миши в Telegram — https://t.me/tricky_python Канал Moscow Python в Telegram — https://t.me/moscow_python Все выпуски — https://podcast.python.ru Митапы Moscow Python — https://moscowpython.ru Канал Moscow Python на Rutube — https…

9 months назад @ learnpython.podbean.com
Новости мира Python за январь 2026

Чтобы научиться программировать и разбираться в тонкостях Python 3.12 записывайтесь на базовый курс Learn Python — https://clck.ru/3MuShF Новости выпуска: убивают ли Python инкрементальные улучшения

релиз Pandas 3.0 недавние тренды Django Security Team в CPython и psutils избавились от busy-polling при работе с subprocess PyPI в 2025 году

PEP 822 — d-string или новый синтаксис для многострочных строковых литералов без лишних отступов Ведущие – Григорий Петров и Михаил Корнеев

Ссылки выпуска:

Курс Learn Python — https://learn.python.ru/advanced Канал Миши в Telegram — https://t.me/tricky_python Канал Moscow Python в Telegram — https://t.me/moscow_python Все выпуски — https://podcast.python.r…

9 months назад @ learnpython.podbean.com
Как команды используют LLM: агенты, ревью и единый инструмент

Чтобы научиться программировать и разбираться в тонкостях Python 3.12 записывайтесь на базовый курс Learn Python — https://clck.ru/3MuShF Ведущие – Григорий Петров и Михаил Корнеев Ссылки выпуска:

Курс Learn Python — https://learn.python.ru/advanced

Канал Миши в Telegram — https://t.me/tricky_python

Канал Moscow Python в Telegram — https://t.me/moscow_python Все выпуски — https://podcast.python.ru

Митапы Moscow Python — https://moscowpython.ru Канал Moscow Python на Rutube — https://rutube.ru/channel/45885590/

Канал Moscow Python в VK — https://vk.com/moscowpythonconf

9 months, 2 weeks назад @ learnpython.podbean.com
Podlodka Podcast Podlodka Podcast
последний пост 6 days, 15 hours назад
Podlodka #501 – Локальные модели для кодинга
Podlodka #501 – Локальные модели для кодинга Podlodka #501 – Локальные модели для кодинга

Подписка на облачного кодинг-агента стоит не так уж дорого. Зачем тогда покупать GPU и запускать модель самому? Вместе с Иваном Опариным из Wildberries разбираемся, какие локальные модели уже годятся для агентной разработки, где они уступают облачным, сколько стоит железо под них и как настраивать их под свою кодовую базу. А самое главное – дадим подробный гайд по тому, как решить свою первую задачу с помощью агента на локальной модели, и по тому, как внедрить их в свою ежедневную работу. Хочешь стать главным экспертом по AI в своей команде? Один из лучших способов – перенимать опыт у тех, кто уже внедряет AI и набивает шишки на практике. Вступай в Podlodka AI Engineers Club – закрытое сооб…

6 days, 15 hours назад @ soundcloud.com
Podlodka #500 – Будущее разработки
Podlodka #500 – Будущее разработки Podlodka #500 – Будущее разработки

500 выпусков и девять с половиной лет разговоров про IT – пора проверить, какие из наших убеждений ещё работают. Собрались полным составом, похвастались навайбкоженными проектами и обсудили, как AI изменил нашу собственную работу. Отдельно поспорили о судьбе инди-хакинга: как меняется создание собственных продуктов, когда код можно поручить агенту, и стоит ли ждать волны независимых разработчиков? А дальше зарубились про будущее разработки. Есть ли ещё смысл в кроссплатформе, насколько хорошо нужно знать стек, на котором пишет агент, и что посоветовать человеку, который только собирается войти в IT? Местами тревожно, местами смешно. Для тех, кто уже пишет код с AI или пытается понять, чему …

1 week, 6 days назад @ soundcloud.com
Podlodka #499 – AI для самопомощи и психотерапии
Podlodka #499 – AI для самопомощи и психотерапии Podlodka #499 – AI для самопомощи и психотерапии

Рассказать AI о своих переживаниях бывает проще, чем записаться к психологу: он терпеливо выслушает даже в три часа ночи и, кажется, неплохо вас поймёт. Но достаточно ли этого, чтобы стало лучше? В этом выпуске вместе с Натальей Кисельниковой разбираемся, что исследования говорят об эффективности такой помощи, с какими запросами AI может справиться, а в каких случаях на него точно не стоит полагаться. А ещё заглянем по другую сторону терапии: как сами специалисты используют AI в своей практике и как это меняет работу психотерапевта.

Также ждем вас, ваши лайки, репосты и комменты в мессенджерах и соцсетях! Telegram-чат: https://t.me/podlodka Telegram-канал: https://t.me/podlodkanews Twitter-…

3 weeks назад @ soundcloud.com
Podlodka #498 – Как поднимать инвестиции
Podlodka #498 – Как поднимать инвестиции Podlodka #498 – Как поднимать инвестиции

Тема стартапов неисчерпаема, и в этот раз мы сосредоточились на самой нервной и драматичной её части — фандрейзинге. Аня Коган, CEO Fitwise и руководитель разработки OpenCV.ai, поделилась искренней историей о том, как она поднимала раунд. Обсудили процесс поиска инвесторов и подготовки питч-дека, разницу в мышлении инвесторов и фаундеров, психологию отказов и то, как AI меняет весь венчурный ландшафт.

Спойлер: теперь не только идея ничего не стоит, но и реализацией впечатлить сложновато, а вот раскрученная ферма TikTok-аккаунтов вполне может стать весомым аргументом для инвестора. За остальными инсайтами — скорее включайте выпуск! Также ждем вас, ваши лайки, репосты и комменты в мессенджера…

3 weeks, 5 days назад @ soundcloud.com
Podlodka #497 – Что происходит с аутсорсом в 2026
Podlodka #497 – Что происходит с аутсорсом в 2026 Podlodka #497 – Что происходит с аутсорсом в 2026

Заказная разработка переживает сложные времена: проектов меньше, клиенты экономят, а AI заставляет пересматривать модель работы. В первой части говорим с Денисом Германенко, СЕО CleverPumpkin. Он рассказывает, что происходит с рынком мобильной разработки в России, какие проекты еще отдают подрядчикам и за что им готовы платить. Во второй части обсуждаем те же перемены с Ириной Назаровой, CEO Evil Martians, специализирующихся на аутсорсе для стартапов в США: кому достается выгода от ускорения разработки, как изменились найм и размер команд, и кто будет переписывать завайбкоженные проекты. Также ждем вас, ваши лайки, репосты и комменты в мессенджерах и соцсетях! Telegram-чат: https://t.me/pod…

1 month назад @ soundcloud.com
Podlodka #496 – RAG
Podlodka #496 – RAG Podlodka #496 – RAG

Несколько лет назад никто толком и не знал, что такое RAG, а сейчас трудно себе представить агентскую работу без них. Retrieval augmented generation - что это такое, и почему скрестить LLM с поиском оказалось такой удачной идеей - разбираемся в выпуске! Также ждем вас, ваши лайки, репосты и комменты в мессенджерах и соцсетях! Telegram-чат: https://t.me/podlodka Telegram-канал: https://t.me/podlodkanews Twitter-аккаунт: https://twitter.com/PodcastPodlodka Ведущие в выпуске:

Женя Кателла, Катя Петрова Полезные ссылки: AI Engineering Buildcamp: From RAG to Agents

https://maven.com/alexey-grigorev/from-rag-to-agents AI Engineering Field Guide

https://github.com/alexeygrigorev/ai-engineering-fie…

1 month, 1 week назад @ soundcloud.com
Podlodka #495 – AI в математике
Podlodka #495 – AI в математике Podlodka #495 – AI в математике

Ещё год назад AI в математике осиливал разве что олимпиадные задачки. Сегодня промпт «сделай научный прорыв» разваливает гипотезу почти тридцатилетней давности, а OpenAI заявляет решение Навье–Стокса силами десяти тысяч агентов. Вместе с Александром Куликовым, доктором физико-математических наук и исследователем JetBrains, разбираемся, где здесь красивая история и маркетинг, а где – настоящий результат, который не только удивляет, но и пугает математическое сообщество, и почему филдсовские медалисты отвечают на всё это письмами протеста. Также ждем вас, ваши лайки, репосты и комменты в мессенджерах и соцсетях! Telegram-чат: https://t.me/podlodka Telegram-канал: https://t.me/podlodkanews Twi…

1 month, 2 weeks назад @ soundcloud.com
Podlodka #494 – Как развить вкус к кино
Podlodka #494 – Как развить вкус к кино Podlodka #494 – Как развить вкус к кино

Иван Талачев, автор и ведущий подкастов «Горящий Бензовоз» и «Один дома», помогает разобраться, как выбирать фильмы без мучительного листания рейтингов, списков и рекомендаций. Обсуждаем трейлеры, чужие рецензии, FOMO и момент, когда фильм можно спокойно выключить. Разбираемся, как развивать насмотренность и понимать киноязык, обязательно ли любить артхаус, где проходит граница между авторским и коммерческим кино и что AI меняет в кинопроизводстве. Выпуск для слушателей, которые хотят смотреть кино осознаннее, но не превращать увлечение в работу. Также ждем вас, ваши лайки, репосты и комменты в мессенджерах и соцсетях! Telegram-чат: https://t.me/podlodka Telegram-канал: https://t.me/podlodk…

1 month, 3 weeks назад @ soundcloud.com
Podlodka #493 – Выгорание от AI
Podlodka #493 – Выгорание от AI Podlodka #493 – Выгорание от AI

Вроде код за вас пишет AI, но вы весь день проверяете результаты и к вечеру не можете объяснить, что вообще сделали. Вместе с кандидатом психологических наук Натальей Кисельниковой разбираемся, как появились термины brain fry, deskilling и что они означают, как меняется нагрузка при работе с агентами и почему это состояние не стоит автоматически приравнивать к привычному выгоранию. Обсуждаем, что делать, пока агент работает, зачем оставлять себе простые задачи и как перестать бросаться на каждую новую модель. На примерах ревью кода разбираем ловушку иллюзорного ускорения, потерю ощущения авторства и признаки перегруза команды, на которые стоит смотреть тимлиду. А ещё спорим, можно ли отдыха…

2 months назад @ soundcloud.com
Podlodka #492 – Как сохранить суставы?
Podlodka #492 – Как сохранить суставы? Podlodka #492 – Как сохранить суставы?

Колено хрустнуло, щёлкает плечо? Не спеши бежать к врачу! В этом выпуске с ортопедом-хирургом Львом Кнеллером разбираемся, сколько на самом деле «живут» суставы и от чего зависит их срок службы. Проходим по самым частым историям пациентов и популярным мифам и маркетингу вокруг здоровья суставов: что работает, а что нет. А ещё говорим о диагностике, стоимости лечения, о том, как выбрать врача, и почему сохранить суставы куда проще, чем потом их чинить. Также ждем вас, ваши лайки, репосты и комменты в мессенджерах и соцсетях! Telegram-чат: https://t.me/podlodka Telegram-канал: https://t.me/podlodkanews Twitter-аккаунт: https://twitter.com/PodcastPodlodka Ведущие в выпуске:

Аня Симонова, Егор …

2 months, 1 week назад @ soundcloud.com
Podlodka #491 – Культивируемое мясо
Podlodka #491 – Культивируемое мясо Podlodka #491 – Культивируемое мясо

Вырастить стейк в биореакторе? Делать котлеты и сосиски из настоящих мышечных тканей, при этом не трогая животных? Звучит как фантастика, но на самом деле это уже реальность. Вопрос как всегда в том, какова цена. Вместе с Юлией Елисеевой разбираемся, почему ни промышленность, ни общество еще не готовы. Также ждем вас, ваши лайки, репосты и комменты в мессенджерах и соцсетях! Telegram-чат: https://t.me/podlodka Telegram-канал: https://t.me/podlodkanews Twitter-аккаунт: https://twitter.com/PodcastPodlodka Ведущие в выпуске:

Женя Кателла, Катя Петрова Полезные ссылки: Профиль Юлии на LinkedIn

https://www.linkedin.com/in/julia-eliseeva-413059120/ Мясо из мамонта

https://www.mammothmeatball.com/…

2 months, 2 weeks назад @ soundcloud.com
Podlodka #490 – AI-агенты Deep Dive
Podlodka #490 – AI-агенты Deep Dive Podlodka #490 – AI-агенты Deep Dive

Вадим Брилиантов создал и был техлидом Koog – фреймворка для AI-агентов на Kotlin. В выпуске разбираем, что на самом деле отличает агента от чат-бота: цикл, инструменты, память и контекст, и почему харнесс почти всегда держится на детерминированном коде, а не на модели. Вадим сравнивает архитектурные решения при построении агентов, объясняет, зачем нужна персистентность состояния и возобновление сессий, и где жёсткий граф-подход упирается в потолок. Отдельно поговорили про кодинг агентов. Разбираем, можно ли менять модель под капотом харнесса без потерь, почему промпты и skills лучше работают, если их писала та же модель, что их использует, зачем нужен ACP, почему A2A не взлетел. Если вам и…

2 months, 3 weeks назад @ soundcloud.com
Podlodka #489 – Laravel
Podlodka #489 – Laravel Podlodka #489 – Laravel

Laravel любят за скорость разработки, ругают за магию и регулярно обвиняют в том, что он плодит жирные контроллеры. Вместе с Аделем Файзрахмановым – автором плагина Laravel Idea для PhpStorm и книги «Архитектура сложных веб-приложений. С примерами на Laravel» – разбираемся, что именно делает этот фреймворк лучшим на сегодняшний день способом писать код на PHP. Также ждем вас, ваши лайки, репосты и комменты в мессенджерах и соцсетях! Telegram-чат: https://t.me/podlodka Telegram-канал: https://t.me/podlodkanews Twitter-аккаунт: https://twitter.com/PodcastPodlodka Ведущие в выпуске:

Евгений Кателла, Егор Толстой Полезные ссылки: Сайт Laravel

https://laravel.com/ Книга «Архитектура сложных веб-…

3 months назад @ soundcloud.com
Podlodka #488 – UX-ресерч в эпоху AI
Podlodka #488 – UX-ресерч в эпоху AI Podlodka #488 – UX-ресерч в эпоху AI

Когда вообще стоит проводить UX-исследование? А когда оно только тратит время и деньги? В этом выпуске разбираемся, в каких случаях ответ уже можно найти в аналитике или саппорте, когда проблема и так очевидна, а когда ещё слишком рано что-либо исследовать, потому что даже гипотезы решения нет. В гостях – Григорий Крутоус, руководитель UX Research в Muse Group (Ultimate Guitar, MuseScore, MuseHub и Audacity). Конечно, не обошлось без разговора про AI: обсудили AI-персон, AI-модерируемые интервью, AI-репозиторий знаний, который строят в Muse Group, и то, могут ли языковые модели разбирать и агрегировать открытые ответы в опросах. Avito.Tech.Conf — конференция от AvitoTech для тех, кто управл…

3 months, 1 week назад @ soundcloud.com
Podlodka #487 – Elixir
Podlodka #487 – Elixir Podlodka #487 – Elixir

Elixir часто воспринимают как более дружелюбный синтаксис поверх Erlang, но достаточно ли такого объяснения в 2026 году? Вместе с Данилой Поярковым, разработчиком более 50 open source проектов для Elixir с суммарно около миллиона скачиваний, разбираемся, что язык унаследовал от Erlang и BEAM, где его используют сегодня и насколько зрелой стала его экосистема. Обсуждаем Phoenix и LiveView, метапрограммирование и Ecto, конкурентность и производительность BEAM. Отдельно смотрим на ML-инструменты NX, Axon, Bumblebee и Livebook, интеграцию с Rust и библиотеки вокруг Elixir. В финале говорим о пригодности для вайбкодинга, AI-агентах и будущем языка. Получился интересный выпуск для тех, кто выбира…

3 months, 2 weeks назад @ soundcloud.com
Проветримся! Проветримся!
последний пост 1 month, 3 weeks назад
Иван Куклев: искусственный интеллект и фармакология

Иван Куклев, работает медицинским советником в онкологии и редких заболеваниях. Помогает врачам лучше разобраться с результатами клинических исследований и видит изнутри, как индустрия решает, какое лекарство дойдёт до пациента. Поговорили о том, где в этих решениях проходит этическая граница и что в них меняет AI. Support the show ApplePodcasts: https://apple.co/2Psx8yd Я.Музыка: https://clck.ru/JJB8y Патреон: https://www.patreon.com/progulka

1 month, 3 weeks назад @ buzzsprout.com
Никита Ильтяков: реклама в больших языковых моделях

Никита Ильтяков — студент программы по искусственному интеллекту AI360 от Яндекса, Сбера и 5 ведущих технических вузов. Никита сооснователь стартапа Gradius, который интегрирует контекстную рекламу в ответы нейросетей. Проект стал победителем Yandex AI Startup Lab в этом году. Support the show ApplePodcasts: https://apple.co/2Psx8yd Я.Музыка: https://clck.ru/JJB8y Патреон: https://www.patreon.com/progulka

2 months назад @ buzzsprout.com
Евгений Датский: углеродные кредиты

Евгений Датский CTO компании carbonHQ. https://carbonhq.earth/ Support the show ApplePodcasts: https://apple.co/2Psx8yd Я.Музыка: https://clck.ru/JJB8y Патреон: https://www.patreon.com/progulka

4 months назад @ buzzsprout.com
Матвей Кукуй: Archestra AI

Матвей Кукуй — CEO и сооснователь платформы для оркестрации ИИ агентов Archestra AI. https://archestra.ai/ Support the show ApplePodcasts: https://apple.co/2Psx8yd Я.Музыка: https://clck.ru/JJB8y Патреон: https://www.patreon.com/progulka

5 months, 1 week назад @ buzzsprout.com
Claude Mythos: кибербезопасность всё?

Давайте разберёмся, что такое Claude Mythos и на что стоит обратить внимание в контексте самого шумного релиза моделей в апреле. телеграм подкаста: https://t.me/progulka Support the show ApplePodcasts: https://apple.co/2Psx8yd Я.Музыка: https://clck.ru/JJB8y Патреон: https://www.patreon.com/progulka

6 months назад @ buzzsprout.com
Екатерина Кухтенко: диагностика вирусных заболеваний

Екатерина Кухтенко — фаундер стартапа VAir. VAir позволяет точно детектировать ряд вирусов в дыхании пациента. 11 Support the show ApplePodcasts: https://apple.co/2Psx8yd Я.Музыка: https://clck.ru/JJB8y Патреон: https://www.patreon.com/progulka

6 months, 1 week назад @ buzzsprout.com
Говард Tёрман: Иисус и те, кому нечего терять

Сегодня делаем обзор книги Говарда Тёрмана Книга: https://en.wikipedia.org/wiki/Jesus_and_the_Disinherited "Бродский" о доставке: https://www.instagram.com/reel/DXPziC8DH_0/ Свежий сабстак: https://caput.substack.com/p/it-is-not-your-ai Support the show ApplePodcasts: https://apple.co/2Psx8yd Я.Музыка: https://clck.ru/JJB8y Патреон: https://www.patreon.com/progulka

6 months, 3 weeks назад @ buzzsprout.com
Андрей Себрант: экзоскелеты и роботы

Андрей Себрант — директор Яндекса по стратегическому маркетингу, автор и ведущий подкаста "Трёп Себранта", автор телеграм канала TechSparks. Подкаст: https://sebrant.chat/ Канал: https://t.me/techsparks Support the show ApplePodcasts: https://apple.co/2Psx8yd Я.Музыка: https://clck.ru/JJB8y Патреон: https://www.patreon.com/progulka

8 months, 2 weeks назад @ buzzsprout.com
Comand Line Heroes by RedHat Comand Line Heroes by RedHat
последний пост None
Python Bytes Python Bytes
последний пост 6 days, 20 hours назад
#503 It’s not 85% HTML
#503 It’s not 85% HTML #503 It’s not 85% HTML

Topics include Your GitHub language bar is lying (how to fix it), Python Typing Survey 2026: developers mix type checkers, and AI is writing the hints, Flask Vibe - Build Apps You Can Understand, and Python on my wrist: MicroPython on a PineTime.

6 days, 20 hours назад @ pythonbytes.fm
#502 Introducing chameleon-rs
#502 Introducing chameleon-rs #502 Introducing chameleon-rs

Topics include , chameleon-rs, Bringing uv and ty together, and Stlite runs Streamlit apps entirely in the browser.

1 week, 6 days назад @ pythonbytes.fm
#501 A Nod to Sir-Mix-Alot
#501 A Nod to Sir-Mix-Alot #501 A Nod to Sir-Mix-Alot

Topics include Nod: pause your Python program and open a notebook at any line, Polars 2.0 ships: streaming engine by default, spill-to-disk, and a row-order gotcha, django-cachalot caches your ORM queries and invalidates them for you, and Towards async transactions in Django.

2 weeks, 6 days назад @ pythonbytes.fm
#500 Episode 500!
#500 Episode 500! #500 Episode 500!

Topics include and.

3 weeks, 5 days назад @ pythonbytes.fm
#499 So many questions??
#499 So many questions?? #499 So many questions??

Topics include PEP 824 brings ?? and ??= to Python for None handling, Python 3.15 Python 3.10, asyncio.shield, and Pyxel: the retro game engine for Python.

1 month назад @ pythonbytes.fm
#498 A Tiny Episode
#498 A Tiny Episode #498 A Tiny Episode

Topics include MemTensor / MemoryOS PyPI package hijacked via a malicious build backend, TinyMongo, , and One innocent dict read makes attribute access permanently slower.

1 month, 1 week назад @ pythonbytes.fm
#497 Faster than light profiling
#497 Faster than light profiling #497 Faster than light profiling

Topics include Tachyon: A sampling profiler ships in Python 3.15's stdlib, Python Workers are now generally available on Cloudflare, Flet 1.0 - build cross-platform apps in Python, and marimo-book: Build static books from marimo notebooks.

1 month, 2 weeks назад @ pythonbytes.fm
#496 A lake house in Seattle
#496 A lake house in Seattle #496 A lake house in Seattle

Topics include Pandas Should Go Extinct, Pydantic-pint puts real-world units in your Pydantic models, How Libraries Run Rust Inside Python (With PyO3), and AWS acquires DuckLabs.

1 month, 3 weeks назад @ pythonbytes.fm
#495 Banned
#495 Banned #495 Banned

Topics include EuroPython 2026 videos are online, The State of Django 2026: Boring is so back, htmx 4.0.0 has been released, and Functionally Zen.

2 months назад @ pythonbytes.fm
#494 Python Wrapture
#494 Python Wrapture #494 Python Wrapture

Topics include OpenAI's Python SDK has migrated to HTTPX2, TMOG - Native Task Manager for macOS, Windows, and Linux, wrapture - one wrapper for mocking, tracing, and observability, and linkedin2md.

2 months, 1 week назад @ pythonbytes.fm
#493 CalVer and LTS
#493 CalVer and LTS #493 CalVer and LTS

Topics include Web UIs for your reverse proxy, , , and Django’s annual releases make every version an LTS.

2 months, 2 weeks назад @ pythonbytes.fm
#492 Codeberg Puts Head in Sand
#492 Codeberg Puts Head in Sand #492 Codeberg Puts Head in Sand

Topics include , Codeberg’s AI-code ban tests its role as a GitHub alternative, , , , and.

2 months, 3 weeks назад @ pythonbytes.fm
#491 Feeling Judged
#491 Feeling Judged #491 Feeling Judged

Topics include , Post-quantum crypto lands in Python, MCP goes stateless — and FastMCP gets renamed, and inshellisense - IDE style command line auto complete.

2 months, 4 weeks назад @ pythonbytes.fm
#490 It’s a vibe coding party
#490 It’s a vibe coding party #490 It’s a vibe coding party

Topics include Some more things about Django I've been enjoying, Who cleans up after the vibe-coding party, AgentsView, and.

3 months, 2 weeks назад @ pythonbytes.fm
#489 Or JSON?
#489 Or JSON? #489 Or JSON?

Topics include django-orjson, Best Django Redis configuration for speed and size, puts the foot down, and Django Steering Council backs the Triptych Project.

3 months, 3 weeks назад @ pythonbytes.fm
Software Engineering Daily Software Engineering Daily
последний пост 4 days, 14 hours назад
SED News: PHP’s Megabug, a Hidden Mic at OpenAI, and Dead AI Products

SED News is a monthly podcast from Software Engineering Daily where hosts Gregor Vand and Sean Falconer break down the biggest stories shaping software engineering, Silicon Valley, and the broader tech industry.

In this episode, Gregor and Sean cover the PHP remote code execution flaw that hit an estimated 70 percent of the internet, the recording device an OpenAI employee hid in a conference room, and a busy run of deals including Chroma joining Replit, Cloudflare taking Deno, and Supabase acquiring Turso.

The main topic tours the AI graveyard, sorting recent product failures into patterns: features swallowed by bigger platforms, runaway hits too costly or risky to sustain, interfaces made…

4 days, 14 hours назад @ softwareengineeringdaily.com
Demis Hassabis and the Race to Build AI with Sebastian Mallaby

Demis Hassabis founded DeepMind in 2010, before machines could reliably tell a cat from a dog. He believed that artificial general intelligence was achievable, and that it should be built safely and deliberately. Along the way, Hassabis shared the 2024 Nobel Prize in Chemistry for AlphaFold, the system that cracked the fifty-year problem of predicting protein structures. Fifteen years on, the LLM race has erupted across rival labs and countries, and AI has become one of the most consequential and contested technologies of the era.

Sebastian Mallaby is a two-time Pulitzer Prize finalist and a longtime chronicler of the collision between innovation and capital, from hedge funds to central ban…

6 days, 14 hours назад @ softwareengineeringdaily.com
AI Regulation and What Every Tech Company Should Know

The rapid rise of AI has set off a flurry of legal and regulatory activity. There is no single AI law to follow. Instead, there are overlapping circles of regulation, where privacy, cybersecurity, consumer protection, employment, and IP laws all continue to apply alongside newer AI-specific rules. Europe has its EU AI Act, but the U.S. has no federal equivalent yet. In its place is an emerging patchwork of more than 150 state AI laws, and the picture shifts every few months as new legislation and guidelines arrive. For engineers and tech companies, it can feel impossible to know what applies and where the real risks lie.

Shannon Yavorsky is a data lawyer who co-leads the Cyber, Privacy and …

1 week, 4 days назад @ softwareengineeringdaily.com
Managing AI Coding Costs at Scale

Over the past couple of years, companies raced to get their employees using AI, often encouraging them to lean on it as much as possible. However, as AI coding tools spread through engineering teams, many companies watched their AI bills explode. That kind of runaway cost growth can threaten a business, so the new challenge is capturing the productivity gains from AI without the spending spiraling out of control.

Databricks is a data and AI company that hit this problem early, running AI tools across thousands of its own engineers. Rather than clamp down on usage, the team built a set of practical ways to manage the cost, from taking advantage of steadily falling model prices to automatical…

1 week, 6 days назад @ softwareengineeringdaily.com
Blitzy and Autonomous Software Development for Enterprise

Codebases in enterprise organizations often span hundreds of thousands, or even millions, of lines of code. In many cases, changes must follow established patterns precisely, or risk introducing costly security or operational issues. A common challenge with AI coding tools is that they struggle at this scale: LLM context windows cover only a fraction of a large codebase, and output quality degrades the longer an agent runs.

Blitzy is an autonomous software development platform for the enterprise. It starts by understanding your entire codebase, building a knowledge graph that acts as a shared source of truth. From a well-defined spec that engineers review and approve, it orchestrates specia…

2 weeks, 4 days назад @ softwareengineeringdaily.com
Physical AI at NVIDIA

In recent years, the main impact of AI has been on the digital world, and most notably software engineering. However, its longer-term effect on the physical world may prove even more profound, reshaping how cars drive themselves, how factories run, and how robots move through homes and warehouses.

World models are at the center of the movement to bring AI into the physical space. These models take in observations of the current state of the world and predict what comes next, which lets a robot plan its next move or a car anticipate the road ahead. NVIDIA has been building a family of these models called Cosmos, and sits at the frontier of physical AI and robotics.

Amit Goel has been at NVID…

2 weeks, 6 days назад @ softwareengineeringdaily.com
Software Verification in the Age of Coding Agents

Software testing is widely understood as essential to building reliable systems, and it’s one of the hardest things to get right. A fundamental issue is that tests are good at confirming the behavior a team expects, but the most damaging failures tend to hide in the edge cases no one thought to check during development. Those blind spots are only growing as AI produces more code that no human has closely reviewed.

Antithesis is a software verification company built around an approach called deterministic simulation testing. The platform runs a customer’s software in a fully controlled environment, exploring thousands of different paths through it at runtime. Crucially, the paths aren’t pre-…

3 weeks, 4 days назад @ softwareengineeringdaily.com
SED News: Jev, Meta’s Muse, and the AI Slowdown Paradox

SED News is a monthly podcast from Software Engineering Daily where hosts Gregor Vand and Sean Falconer break down the biggest stories shaping software engineering, Silicon Valley, and the broader tech industry.

In this episode, Gregor and Sean cover a wave of new product drops, including Jev from TypeSafe AI, a model that returns scored, type-safe structured responses for machine-to-machine tasks like routing and classification rather than human-style chat. They also dig into Meta‘s Muse, a personal AI assistant with a companion keychain device, and the upcoming IPO of Nscale, a former crypto-mining outfit turned “neocloud” inference provider whose filing leans heavily on a single unnamed …

3 weeks, 6 days назад @ softwareengineeringdaily.com
Steve Jobs in Exile
Steve Jobs in Exile

The popular story of Steve Jobs is that he co-founded Apple, was pushed out, wandered through a failed venture called NeXT, then returned to save the company and usher in the iPod and iPhone. That version is memorable, widely repeated, and, in an important sense, wrong. His years at NeXT are usually treated as a footnote, when they were among the most consequential of his life and career.

Geoffrey Cain is the author of Steve Jobs in Exile, which draws on previously unpublished material and new interviews to illuminate the NeXT years. The book argues that NeXT was not a failure but the hidden turning point. Its operating system, NeXTSTEP, became the foundation of Mac OS X and, later, the iPh…

1 month назад @ softwareengineeringdaily.com
Security in the Age of Instant Exploits

In the world of software security, there was historically a comfortable lag between the moment a vulnerability became public and the moment attackers could exploit it. This lag was often measured in months, but AI models can now read a vulnerability report and generate a working exploit almost instantly. They can scan the entire internet for exposed secrets at a scale no human team could match, and surface complex flaws that traditional tools missed for years. However, the same capabilities are just as available to defenders, and there is a case to be made that defenders hold the stronger hand.

Alon Schindel is the VP of AI and Threat Research at Wiz, which is a cloud security platform acqu…

1 month назад @ softwareengineeringdaily.com
The State of Browser Testing

Automated browser testing is a foundational technology that many web developers rely on. Modern tooling lets a single test drive Chrome, Firefox, and Safari the same way, a triumph of software engineering built on years of standardization work. That standardization emerged from the interplay between open source projects, browser vendors, and standards bodies like the W3C.

David Burns is a longtime Selenium and WebDriver contributor, a veteran of Mozilla, and is currently the Head of Developer Advocacy and Open Source at BrowserStack. In this episode, David joins Josh Goldberg to discuss how open source projects, browser vendors, and standards bodies fit together, a practical philosophy of t…

1 month, 1 week назад @ softwareengineeringdaily.com
Cory Doctorow on AI, Work, and Power

Cory Doctorow is a science fiction author, journalist, and technology activist, and a special advisor to the Electronic Frontier Foundation. He is the author of dozens of books, including the nonfiction Enshittification: Why Everything Suddenly Got Worse and What to Do About It and the novel Picks and Shovels. His work spans tech policy books like The Internet Con and Chokepoint Capitalism, the solarpunk novels Walkaway and The Lost Cause, and the bestselling YA Little Brother series. He holds honorary doctorates from York University and the Open University, writes the daily blog Pluralistic.net, and lives in Los Angeles and London.

In this episode, Cory joins Josh Goldberg to talk about hi…

1 month, 1 week назад @ softwareengineeringdaily.com
Chroma and Agentic Retrieval

Data retrieval is a fundamental challenge in AI systems, and the approaches for solving it are still evolving. Vector search was an early answer to the retrieval problem, but the rise of agentic systems has raised the stakes considerably. Agents issue queries at machine speed, decompose complex questions into parallel searches, and require retrieval infrastructure that can keep pace without becoming prohibitively expensive.

Chroma is a company building open source infrastructure for AI applications, best known for its widely used database of the same name. The company also published the influential Context Rot paper, which documented how model performance degrades as context window utilizat…

1 month, 2 weeks назад @ softwareengineeringdaily.com
Scaling Time-Series Workloads on Postgres

Many real-world processes produce data as a continuous stream rather than as isolated records. Sensor readings, financial markets, and application telemetry all generate data this way. This kind of time-series data has a distinctive shape. It’s written far more often than it is updated, it accumulates continuously, and it is usually queried across ranges of time. Time-series databases are built specifically for this kind of workload.

TimescaleDB is an open source database from Tiger Data that adds time-series capabilities to PostgreSQL. It’s implemented as a Postgres extension, so it introduces new functionality while preserving standard Postgres behavior and SQL. This lets a single Postgre…

1 month, 2 weeks назад @ softwareengineeringdaily.com
Scaling Agent Workloads at Vercel

Most AI agent setups today are built around a single session, where one user interacts with one agent at a time. However, that model breaks down when an agent has to serve a business, where thousands of requests can arrive at once and each session needs to be isolated, durable, and recoverable. Getting agents to run reliably at that scale has meant a lot of hand-rolled infrastructure beneath the agent itself.

eve is an open source, cloud-native agent framework from Vercel that removes much of the agent scaling burden. In the eve framework, an agent is defined declaratively through configuration files and these files compile into infrastructure as code so the platform provisions only what th…

1 month, 3 weeks назад @ softwareengineeringdaily.com
Habr Podcasts Habr Podcasts
последний пост None
Мысли и Методы Мысли и Методы
последний пост None
Трёп Себранта Трёп Себранта
последний пост None
⌨ Coding
Martin Fowler
последний пост 4 days, 10 hours назад
The Data Product Platform Navigator
The Data Product Platform Navigator The Data Product Platform Navigator

To build a complete data product, we need various technologies such as compute to run data transformations, data storage, data ingestion tools, data catalogs, query engines, quality tools, and more.

Consider a first data product developer who sets out to create a new data product.

In this scenario, the organization establishes a dedicated Data Product & Data Mesh Platform Team that treats the platform as a product.

In summary, a data product developer just clicks 'Create Data Product', and the platform wires the technology and infrastructure together as a Data Product.

By removing the knowledge bottleneck, the platform empowers data product developers with more autonomy, which is crucial fo…

4 days, 10 hours назад @ martinfowler.com
Bliki: LLM Voice
Bliki: LLM Voice Bliki: LLM Voice

Sometimes when I read a post, I get the growing feeling that I'm reading the output of an LLM.

I'm also suspicious of my own ability to accurately recognize LLM voice.

In particular I strongly recommend that authors should not fall into the trap of getting the LLM to write a draft.

Some have found LLM translation an important part to their communication with those of us who know rather less Marathi.

There are situations where it would be reasonable for even a native Englishman to let LLMs write the prose.

1 week, 4 days назад @ martinfowler.com
Why are good developers so wary of agentic development?
Why are good developers so wary of agentic development? Why are good developers so wary of agentic development?

TL;DRGood developers’ caution about agentic development comes from knowing that built isn’t the same as working in production.

In September, a discussion we had on agentic development, which pushed it to its limits, finally helped me see clearly what that fear is.

Building it rightThoughtworkers care deeply about building the right thing and building it right.

Were too many agents working in parallel and stepping on each other’s changes?

Developers need to bring their experience into those experiments and be prepared to find that some of their assumptions no longer hold.

1 week, 4 days назад @ martinfowler.com
Fragments: October 28
Fragments: October 28 Fragments: October 28

 ❄                ❄                ❄                ❄                ❄That observation particularly resonates with me today, as I’ve just spent the weekend at Foocamp, an open space event run by O’Reilly.

 ❄                ❄                ❄                ❄                ❄Laurie Voss says today is 1997On Saturday, Apollo’s chief economist Torsten Slok published No Signs of AI Payoff Outside the Tech Sector.

 ❄                ❄                ❄                ❄          …

1 week, 5 days назад @ martinfowler.com
Fragments: October 21
Fragments: October 21 Fragments: October 21

 ❄                ❄                ❄                ❄                ❄I was sad to hear that the Grace Hopper Celebration is canceled this year.

 ❄                ❄                ❄                ❄                ❄I’ve always found Cindy Sridharan’s writing to be worth reading, and she’s broken a quiet period with a monster of an article: How to effectively debug when you no longer understand the code.

The agent first needs to identify the data points in the factual tier that are actually related to the bug.

A table of hypotheses and si…

2 weeks, 5 days назад @ martinfowler.com
When Software Meets Hardware
When Software Meets Hardware When Software Meets Hardware

When software meets hardware, engineering principles remain largely the same, but the sensible defaults often change.

Our team knew software engineering well.

We thought the software engineering skills would apply here too, and it did, the engineering principles remain the same, but the default practices changed.

Consider the physical world part of the development lifecycle In conventional software, the development environment is usually made up of software tools.

This allowed us to exercise the downstream systems at store scale without needing hundreds of physical devices for every test.

3 weeks, 4 days назад @ martinfowler.com
Build your slide template
Build your slide template Build your slide template

Building a slide template starts with three foundational choices — colours, fonts and layouts.

The corporate template If you work at a large enough corporation, your employer may have provided a corporate slide template.

Through the rest of this article, I’ll show you how to build your own template, but you can also use that advice to unpack the key elements of any corporate slide template.

If you understand these fundamentals of font choice and typographic spacing, you have enough typography knowledge to build a slide template.

Try it yourself Before you read the next post, how about building yourself a new slide template?

3 weeks, 5 days назад @ martinfowler.com
The Craft of Practitioner Voice
The Craft of Practitioner Voice The Craft of Practitioner Voice

Practitioner Voice writes for people who recognize the pattern from their own experience.

Practitioner Voice names the tension and leaves it live.

Practitioner Voice is the thing only you can write, because it's built from what only you have lived.

Practitioner Voice opens with the conclusion and “lets the rest of the piece be explanation, not proof.

The braided narrative suits Practitioner Voice because it keeps tension live across multiple dimensions simultaneously.

3 weeks, 6 days назад @ martinfowler.com
Are Harnesses Worth the Cost?
Are Harnesses Worth the Cost? Are Harnesses Worth the Cost?

But a cost-optimized model, GPT-6 Luna, succeeded in only 3 of 10 unharnessed runs and all 10 with the harness.

Both conditions began with the application brief and baseline repository instructions in separate, private workspaces.

The application brief Every attempt began with a detailed application brief.

Unharnessed GPT-6 Luna runs passed 94.8% of the functional checks.

Reusing interface contracts and checks across implementations could spread the setup cost over time, but I did not measure that reuse or the resulting total cost.

3 weeks, 6 days назад @ martinfowler.com
Fragments: October 4
Fragments: October  4 Fragments: October 4

 ❄                ❄                ❄                ❄                ❄DDD Europe have released the video of Gien Verschatse interviewing Eric Evans and myself at the conference in June.

 ❄                ❄                ❄                ❄                ❄Paul Graham:There were a lot of things that only worked because there’s a limit to the rate at which humans can operate.

 ❄                ❄                ❄                ❄                ❄In a later post, Sam pond…

1 month назад @ martinfowler.com
Principles for effective slides
Principles for effective slides Principles for effective slides

It’s an example of the standard-issue slides you’ll see in a corporate infodeck.

While you can use another speaker’s slides, you’ll have to tune them to your delivery approach.

When you thumb through the slides, you’ll see that I reveal each part of the framework in a new snapshot.

Treat slides as integrated visuals If your audience is thinking about your slides, they’re not paying attention to your message.

Presenters often turn slides into cue cards for themselves, and that leads to verbose slides with talking notes on the visual.

1 month, 1 week назад @ martinfowler.com
Bliki: Sensible Default
Bliki: Sensible Default Bliki: Sensible Default

A Sensible Default is a practice that, absent some overriding context, should be used when carrying out a certain kind of task.

In software development such sensible defaults might include things like “use version control”, “separate UI logic from domain logic”, “automate deployment pipelines”.

The term “sensible default” is a deliberate contrast to “best practice”.

A sensible default is what we'd expect you to do, the practices to apply, if there are no hard constraints in the environment.

Searching on the web led me to a post from Steve Bennett on Sensible Defaults.

1 month, 1 week назад @ martinfowler.com
Fragments: September 29
Fragments: September 29 Fragments: September 29

 ❄                ❄                ❄                ❄                ❄Harper Reed explored what turns agents into hackers by creating a breakaway agentIt ran and ran attacking all the machines on the same subnet, and was very effective.

 ❄                ❄                ❄                ❄                ❄Which all makes me think that when it comes to AI and LLMs: why are we wondering if they have consciousness - when we should be wondering why they don’t have a conscience?

 ❄                ❄              …

1 month, 1 week назад @ martinfowler.com
Fragments: September 24
Fragments: September 24 Fragments: September 24

Bowley feels the push to slow down AI is distracting us from the problems that are lurking with current technology.

Too often agents are deployed in situations where they include the Lethal Trifecta, opening up a gaping security hole.

Not because of what the models might become, but because nobody has worked out how to do this safely yet.

 ❄                ❄                ❄                ❄                ❄I ran into Nikita Prokopov’s post: I am sorry, but everyone is getting syntax highlighting wrong.

 ❄                ❄                ❄                ❄ …

1 month, 2 weeks назад @ martinfowler.com
Healthy Feedback
Healthy Feedback Healthy Feedback

Pat helped Sumeet see through one of the biggest myths about feedback — the notion that feedback can be either positive or negative.

Sumeet remembers Pat saying, “All feedback is positive.” Kua listed the only two goals for sharing feedback.

Before we get into the patterns and antipatterns of sharing feedback, let’s list the core principles that underpin this practice.

Situation-behaviour-impact, or SBI, is a popular format for sharing feedback, but we find that seeking context before sharing feedback avoids some of the tension that can build up in a feedback conversation.

Share feedback in private, in real time Feedback to improve effectiveness is often safer in private.

1 month, 2 weeks назад @ martinfowler.com
Антон Жиянов Антон Жиянов
последний пост None